IA sobre dado de sistema legado: por que o agente responde com confiança e erra o significado
A promessa mais vendida de IA corporativa em 2026 é o agente que responde perguntas em linguagem natural sobre os dados da empresa. Sobre dado moderno e bem definido, funciona. Sobre dado de sistema legado, falha de um jeito específico e perigoso: o agente lê o esquema, encontra uma coluna chamada CLI_ATV, assume que significa cliente ativo e devolve um número que na verdade mistura três regras de negócio abandonadas ao longo dos anos. A resposta vem completa, bem formulada e errada, e ninguém a questiona porque parece plausível. Governança de dado para IA sobre legado, por isso, não começa por permissão nem por mascaramento. Começa por significado. Um agente não pode consultar com segurança um dado cujo nome mente sobre o próprio conteúdo, e o legado é justamente onde nome e conteúdo se divorciaram.
O que o agente vê, e o que ele não vê
Um modelo que recebe acesso a uma base de dados enxerga a estrutura: tabelas, colunas, tipos, e os nomes que alguém deu a tudo isso. É a partir desses nomes e dessa estrutura que ele decide o que consultar para responder uma pergunta. Em um sistema recente, isso basta, porque o nome foi escolhido para descrever o conteúdo e a definição nasceu junto com o dado.
Em um sistema legado, o que o agente vê e o que o dado realmente é se separaram há muito tempo. O nome da coluna reflete uma convenção de uma década passada, ou uma abreviação cujo sentido se perdeu. O conteúdo carrega regras de negócio que mudaram sem que a estrutura mudasse junto. Um campo de status guarda códigos de processos que não existem mais. O agente não tem como saber disso, porque nada no esquema sinaliza. Ele lê o nome, faz a suposição mais razoável, e é a suposição razoável sobre dado enganoso que produz o erro confiante.
A tese deste guia: a IA que consulta dado de legado não erra por falta de capacidade, erra por excesso de confiança sobre um significado que ninguém reconstruiu. E o erro dela é pior que o de uma consulta manual, porque a fluência da resposta esconde a fragilidade da fonte. Um analista que estranha um número investiga; o agente entrega o número com a mesma segurança de quando está certo. Governança de dado para IA no legado, portanto, tem um passo zero que a maioria pula: reconstruir o significado do dado antes de deixar qualquer agente consultá-lo.
A cadeia do erro que ninguém percebe
O modo como esse erro se instala tem uma sequência previsível, e nenhuma etapa dela dispara alarme.
agente lê nome de campo → assume significado plausível →
consulta dado que significa outra coisa →
responde com confiança → decisão tomada sobre número errado
O cenário concreto torna isso tangível. Uma diretoria pergunta ao assistente quantos clientes ativos a empresa tem. O agente encontra a coluna CLI_ATV, soma os registros marcados e responde um número redondo e convincente. Acontece que aquele campo, na origem legada, marcava algo diferente de cliente ativo no sentido atual: incluía contas suspensas de um produto descontinuado, ou excluía um segmento que migrou para outro sistema anos atrás. A resposta entra numa apresentação, orienta uma decisão, e a divergência só aparece quando alguém que conhece a história do sistema, se ainda houver alguém, estranha o número. Governança que não trata o significado antes da IA produz esse tipo de erro em escala, um por pergunta.
As três camadas de governança de dado para IA, na ordem certa
Governança de dado para IA costuma ser apresentada como controle de acesso e proteção de dado sensível, e isso é parte dela. Mas sobre legado, essas camadas vêm depois de uma que quase ninguém nomeia. A ordem importa, porque aplicar as duas últimas sobre a primeira ausente produz governança que parece existir e não protege.
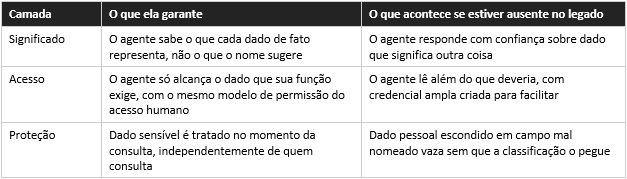
A camada de significado é a que o legado torna difícil e a que a IA torna urgente. Sem ela, a camada de acesso protege alcance sobre dado que ninguém sabe descrever, e a camada de proteção classifica por nome um conteúdo que o nome não revela. É a mesma razão pela qual governança de dado legado, com ou sem IA, começa por reconstruir o significado, tema que aprofundamos em artigo próprio; a diferença é que a IA remove a última barreira humana que ainda pegava o erro, porque ela não hesita diante do dado estranho.
Onde a governança de significado se materializa
O significado reconstruído vira metadado governado (especialista Databricks)
Reconstruir o significado só protege a IA se o resultado for aplicado numa camada que o agente respeite ao consultar. Na plataforma de dados, o significado reconstruído vira definição, marcação e regra que o modelo consome junto com o dado. A documentação da Databricks descreve o Unity Catalog como a camada unificada de governança para dados e IA, com controle de acesso, linhagem, auditoria e descoberta centralizados, e as mesmas permissões valendo para pessoas, notebooks e modelos. É ali que a definição de negócio de cada campo, uma vez recuperada, passa a acompanhar o dado, e onde o mascaramento e a classificação incidem sobre conteúdo conhecido em vez de nome suposto. O agente que consulta a camada curada e governada recebe o dado com o significado anexado, e não o esquema cru do legado onde o nome engana.
A rastreabilidade do trabalho de significado (consultoria Jira)
Reconstruir o significado do dado de um legado é trabalho longo, feito campo a campo, e o que não é registrado se perde e precisa ser refeito. Cada campo cujo sentido foi recuperado, cada regra de negócio antiga documentada, cada decisão sobre qual definição vale precisa virar item com dono, evidência e histórico. No Jira, isso é o backlog da reconstrução de significado tratado como trabalho gerenciado, com o histórico de transições mostrando o que já foi resolvido e o que falta. É o que impede que o conhecimento recuperado volte a virar conhecimento tribal, agora na cabeça de quem conduziu o projeto de IA.
Por que colocar IA no dado legado com segurança exige as duas pontas e uma terceira competência: reconstruir o significado é engenharia reversa de dado, aplicar o resultado é governança de plataforma, e registrar o trabalho é gestão de fluxo. Nenhuma sozinha basta. Quem só liga a IA no dado entrega o erro confiante em escala; quem só governa acesso protege alcance sobre dado sem sentido; quem só documenta produz um dicionário que ninguém aplica. A CSP Tech opera as três, como especialistas Databricks na camada onde o significado governado vive, com consultoria Jira na rastreabilidade da reconstrução, e 34 anos de desenvolvimento de software na leitura do que um sistema legado esconde.
Quando dá para acelerar sem esse cuidado
• IA sobre dado moderno e bem definido. Se o dado que o agente vai consultar nasceu com definição clara e nome que descreve o conteúdo, a camada de significado já existe, e o cuidado se concentra em acesso e proteção.
• Uso exploratório com validação humana obrigatória. Um piloto em que toda resposta do agente passa por quem conhece o dado antes de virar decisão pode tolerar significado ainda incompleto, desde que a validação seja real e não formalidade.
• Significado ainda vivo na equipe. Se as pessoas que operam o legado ainda sabem o que cada campo significa, o dicionário pode ser documentado com menos esforço. O risco cresce quando esse conhecimento depende de quem já saiu.
Perguntas frequentes
Por que a IA erra ao consultar dados de sistema legado?
Porque ela decide o que consultar a partir do nome e da estrutura dos campos, e em sistema legado o nome frequentemente não descreve mais o conteúdo. O agente lê um campo com nome plausível, assume o significado mais razoável e responde com confiança sobre um dado que representa outra coisa, muitas vezes carregando regras de negócio abandonadas. O erro é pior que o de uma consulta manual porque a fluência da resposta esconde a fragilidade da fonte, e o agente não hesita diante do dado estranho como um analista hesitaria.
O que é governança de dados para IA?
É o conjunto de controles que garante que a IA consulte dado confiável, com acesso adequado e proteção do que é sensível. Sobre dado moderno, envolve sobretudo controle de acesso e mascaramento. Sobre dado de sistema legado, há uma camada anterior indispensável: significado. O agente precisa saber o que cada dado de fato representa antes de consultá-lo, ou aplica controle de acesso e proteção sobre um conteúdo que ninguém sabe descrever, o que produz governança aparente e não real.
Como preparar dado de sistema legado para ser consultado por IA?
Começando pela reconstrução do significado, e não pela conexão do agente. O trabalho verifica o que cada campo de fato contém, recupera as regras de negócio antigas embutidas nos valores, reconcilia variações do mesmo conceito e classifica a sensibilidade pelo conteúdo. Esse significado é então aplicado na plataforma de dados como definição e marcação governadas, de modo que o agente consulte a camada curada com o sentido anexado, e não o esquema cru do legado onde o nome engana. Só depois vêm as camadas de acesso e proteção.
Governança de significado substitui controle de acesso da IA?
Não, ela precede. As três camadas são necessárias e têm ordem: significado, acesso e proteção. Sem significado, o controle de acesso protege alcance sobre dado que ninguém sabe descrever, e a proteção classifica por nome um conteúdo que o nome não revela, deixando passar dado sensível escondido em campo mal nomeado. Sobre dado moderno as três podem ser tratadas quase juntas; sobre legado, a de significado vem primeiro porque é a que o sistema antigo destruiu.
Próximo passo
Se a sua empresa planeja colocar IA para responder sobre dados que vivem em sistemas antigos, o risco maior não é a IA acessar o que não deveria, é a IA responder com confiança sobre o que ninguém mais sabe descrever. O passo que torna esse uso seguro é reconstruir o significado antes de conectar o agente. Solicite um diagnóstico de prontidão do seu dado legado para IA com a CSP Tech e receba o mapa do seu caso: quais campos têm significado perdido, onde o agente responderia errado com confiança, e o que precisa ser reconstruído e governado antes de qualquer pergunta em linguagem natural.
Autor: Guilherme Matos, estrategista de conteúdo e IA, certificado HubSpot, Google, Anthropic e Semrush. Revisão técnica por especialistas de dados e Atlassian da CSP Tech (parceira Databricks, Atlassian Gold Partner, Microsoft Gold Partner, participante do Anthropic Partner Network, 34 anos de mercado).
Fontes (acesso set/2026): Databricks Documentation (docs.databricks.com), quanto ao Unity Catalog como camada unificada de governança para dados e IA, com controle de acesso, linhagem, auditoria e descoberta centralizados e permissões aplicáveis a pessoas, notebooks e modelos, e a máscaras de coluna e filtros de linha aplicados no momento da consulta. Atlassian, documentação de Jira quanto a tipos de item, campos e histórico de transições, base do registro do trabalho de reconstrução (atlassian.com). A caracterização do erro da IA sobre dado legado, a ordem das três camadas de governança começando por significado, e a cadeia da resposta confiante e errada são formulação editorial da CSP Tech, e não constituem norma ou padrão de mercado. Os nomes de campo citados, como CLI_ATV, são exemplos ilustrativos e não representam dado de cliente real. Nenhum número de desempenho, prazo ou custo foi citado por ausência de fonte primária verificável. Este conteúdo trata de arquitetura e governança técnica e não constitui aconselhamento jurídico