Quanto custa manter um sistema legado que ninguém mais entende?
Manter um sistema legado crítico consome entre 21% e 40% do gasto total de TI na forma de dívida técnica. O número vem do Deloitte 2026 Global Technology Leadership Study, publicado em 30 de abril de 2026, com base em survey conduzido entre dezembro de 2025 e fevereiro de 2026 com mais de 660 líderes de tecnologia. O gasto raramente aparece como linha do orçamento. Fica diluído em horas de sustentação, em prazos que esticam por medo de mexer no sistema e em projetos que não saem porque o impacto de qualquer mudança é imprevisível. Quando a soma vai ao board, quase sempre chega tarde.
Quanto do orçamento de TI a dívida técnica realmente consome?
Duas medições públicas, com metodologia declarada, dão a ordem de grandeza do custo.
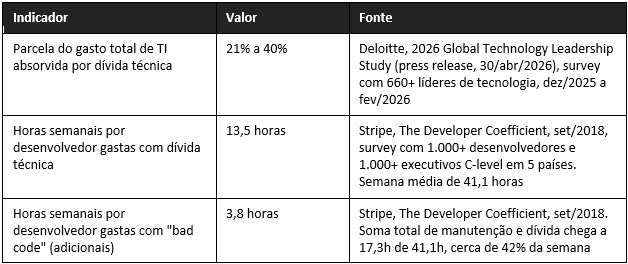
Num time de 40 desenvolvedores, 13,5 horas semanais por pessoa somam 540 horas por semana. É o equivalente a cerca de 13 profissionais em tempo integral mantendo o sistema legado funcionando, em vez de construir o roadmap que a empresa apresentou ao board. O dado do Stripe é de 2018 e serve como ponto de partida enquanto a organização não faz a medição própria.
Por que um sistema legado fica caro sem ninguém tomar uma decisão errada?
O custo de um sistema legado cresce por efeito do tempo. Seis processos acontecem em qualquer software crítico ao longo de uma década, independentemente da qualidade da construção inicial:
● 1. A documentação envelhece. O sistema real passa a existir sobretudo no código, à frente do que está escrito em qualquer manual.
● 2. O conhecimento se dispersa. Parte de quem construiu o sistema saiu da empresa e levou o porquê das decisões junto.
● 3. As dependências ficam implícitas. Acoplamentos que faziam sentido na época deixam de estar explícitos em qualquer lugar.
● 4. A tecnologia evolui e o sistema não. Linguagens, frameworks e infraestrutura mudaram; a base do sistema, não.
● 5. A sustentação ocupa o espaço da evolução. Manter o que existe consome o orçamento que financiaria o que ainda não existe.
● 6. Estimar vira apostar. Sem mapa estrutural, prever o impacto de uma mudança exige uma margem que ninguém sabe justificar no comitê.
Os seis processos são reversíveis. A condição para reverter é recuperar o conhecimento estrutural do sistema, e essa recuperação não depende de escolher já entre modernizar, evoluir ou reescrever.
O que o método oficial da Microsoft recomenda antes de decidir o quê modernizar?
O Microsoft Cloud Adoption Framework, na página "Prepare for cloud modernization" (learn.microsoft.com), orienta o gestor de TI a ranquear cada workload em duas dimensões antes de escolher o caminho: valor de negócio e risco técnico. O framework lista sinais oficiais de high technical debt, entre eles arquitetura difícil de mudar sem quebrar outras partes, código sem cobertura de teste, dependências desatualizadas ou fora de suporte e concentração de conhecimento em poucas pessoas.
A recomendação é combinar as duas leituras em uma matriz de prioridade antes de execução. O framework também aponta triggers de urgência que sobem workloads no ranking mesmo que a prioridade estratégica seja baixa: perda de fornecedor, incidente de segurança, mudança regulatória, expiração de contrato de suporte. A matriz não substitui julgamento executivo. Ela impede que a decisão seja tomada com base apenas em quem grita mais alto no comitê.
Como explicar o custo de um sistema legado para o board?
A explicação cabe em duas curvas. A primeira mostra o custo de manter o sistema em operação. Sobe todo ano, sem que ninguém decida nada. A segunda mostra a capacidade da empresa de evoluir esse sistema. Cai na mesma proporção, pelo mesmo motivo.
A distância entre as duas curvas é o que a empresa paga sem contabilizar, e ela cresce sozinha. Em sistemas legados críticos, adiar a decisão costuma custar mais do que qualquer um dos quatro caminhos possíveis. A inércia é uma escolha, e é raramente a mais barata.
O que muda quando a empresa recupera o mapa estrutural do sistema legado?
Recuperar o mapa estrutural de um sistema legado crítico abre três ganhos que aparecem em áreas diferentes.
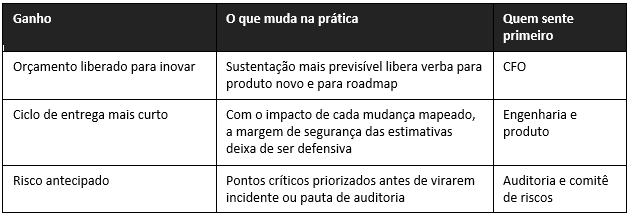
Entender um sistema legado exige começar um projeto de modernização?
Modernizar um sistema legado crítico pode levar anos. Entender o sistema, não. Um diagnóstico estrutural reconstrói o conhecimento do sistema em semanas. O trabalho é feito sobre uma cópia do repositório em ambiente acordado, sem alterar código em produção.
O resultado é um ativo que fica na empresa: documentação derivada do próprio código, mapa de dependências, regras de negócio remapeadas e scorecards de risco e dívida técnica. Com isso, a decisão de manter, evoluir, modernizar ou reescrever deixa de ser opinião e passa a ser escolha entre cenários mensurados. O passo a passo dessa decisão está detalhado neste artigo companheiro (link para o post "Manter, evoluir, modernizar ou reescrever").
Como a sustentação do legado vira rastro de decisão em vez de fila de fogo?
Enquanto o mapa estrutural não existe, a sustentação vive de memória individual. A pessoa que resolveu o último incidente parecido é quem cuida do próximo, o histórico está em thread de e-mail e o supervisor descobre o custo agregado quando fecha a fatura.
A documentação oficial do Jira Service Management (support.atlassian.com) recomenda quatro workflows inspirados em ITIL para IT teams: service request, incident, problem e change. O ganho, para o custo do legado, não é o workflow em si. É a decisão que cada um dos quatro obriga a registrar com dono, data e categoria. Incidente vira registro. Problema recorrente vira análise causal.
Mudança vira aprovação com risco declarado. Solicitação vira demanda com SLA. A soma dessas quatro trilhas transforma a sustentação em série histórica auditável, e é dessa série que sai a base para justificar qualquer caminho ao board.
Ferramenta não substitui método. Um Jira Service Management mal implementado transforma o problema em outro problema. A doc oficial do Atlassian é explícita: os workflows ITIL são framework, não receita. A adaptação para o contexto da operação é responsabilidade do time.
Como a CSP Tech trabalha com sistemas legados críticos?
A CSP Tech é uma consultoria brasileira de desenvolvimento de software customizado, Dados e IA, com 38 anos de mercado e mais de 300 colaboradores. A modernização de sistemas core é uma das frentes da linha de Transformação Digital. A camada Atlassian conta com parceria Gold, que sustenta o desenho de sustentação e ITSM sobre Jira e Jira Service Management.
Próximo passo
Escolha o sistema legado que mais aparece nas reuniões como justificativa de prazo. Uma sessão de 45 minutos com o seu time é suficiente para eleger o sistema-alvo, desenhar o escopo do diagnóstico estrutural e dimensionar a linha de base de custo. Receba um diagnóstico de legado com a CSP Tech e comece com evidência antes do próximo ciclo de planejamento.
Perguntas frequentes
O que é dívida técnica?
Dívida técnica é o custo acumulado de decisões de software que facilitaram a entrega no curto prazo e passaram a exigir retrabalho, manutenção extra ou cautela a cada mudança. Em sistemas legados, a dívida técnica cresce também por obsolescência de linguagens, frameworks e infraestrutura.
Como calcular o custo de manter um sistema legado?
Some as horas de sustentação e correção do sistema, o tempo adicional embutido nas estimativas de mudanças que o envolvem e o valor dos projetos adiados por dependência dele. Enquanto não houver medição própria, a referência de 13,5 horas semanais por desenvolvedor (Stripe, 2018) serve como ponto de partida. O ideal é usar o Jira Service Management, ou a ferramenta ITSM em uso na casa, para acumular a série histórica real e substituir a referência de mercado.
Documentar um sistema legado é o mesmo que modernizá-lo?
Não. Documentar é recuperar o conhecimento do que o sistema faz e de como suas partes se relacionam. Modernizar é mudar tecnologia ou arquitetura. A documentação estrutural é pré-requisito para decidir se, quando e como modernizar. O Microsoft Cloud Adoption Framework recomenda, em "Prepare for cloud modernization", que essa avaliação preceda qualquer decisão de execução.
Diagnosticar um sistema legado exige mexer no código em produção?
Não. Uma leitura estrutural pode trabalhar sobre uma cópia do repositório em ambiente acordado, sem alterar o sistema que está em operação. O resultado é uma reconstrução do mapa arquitetural real, dos módulos e das dependências, entregue como ativo da empresa.
O diagnóstico vale a pena se a decisão for manter o sistema como está?
Sim. O conhecimento estrutural de um sistema crítico é um ativo, independentemente da decisão seguinte. Se o comitê decidir manter o sistema por mais 24 meses, fará isso sabendo qual risco está aceitando e quais pontos monitorar em série no ITSM.
Autor: Guilherme Matos, estrategista de conteúdo e IA, certificado HubSpot, Google, Anthropic e Semrush. Revisão técnica por especialistas de arquitetura, Atlassian e engenharia da CSP Tech (Atlassian Gold Partner, Microsoft Gold Partner, parceira Databricks, participante do Anthropic Partner Network).
Fontes principais (oficiais, acesso set/2026): Deloitte, "From Operators to Orchestrators: Deloitte's 2026 Global Technology Leadership Study Reveals a New Mandate for Tech Leaders", press release (deloitte.com/us/en/about/press-room, 30/abr/2026), com metodologia declarada de survey online com 660+ líderes de tecnologia globais entre dez/2025 e fev/2026; Stripe, "The Developer Coefficient" (stripe.com/files/reports/the-developer-coefficient.pdf, set/2018), survey com 1.000+ desenvolvedores e 1.000+ executivos C-level em cinco países, semana média de 41,1 horas; Microsoft Learn, "Prepare for cloud modernization" e "Assess your workloads for cloud migration", Cloud Adoption Framework (learn.microsoft.com/en-us/azure/cloud-adoption-framework, atualizado em 2025 e 2026); Atlassian Support, "Best practices for IT teams using Jira Service Management" (support.atlassian.com/jira-service-management-cloud). Todas as afirmações atribuídas a essas fontes referem-se ao conteúdo publicado nos releases e páginas oficiais indicados, com metodologia e ano preservados.
Links internos sugeridos: spoke "Manter, evoluir, modernizar ou reescrever um sistema legado crítico: como decidir?"; spoke "Adotamos IA para programar e a entrega não acelerou: por que isso acontece?"; spoke "Por que LLMs erram em sistemas legados, e por que um modelo maior não resolve?"; página institucional da CSP Tech sobre Modernização de sistemas core.