Governança de sistemas legados: você não controla o que não consegue enxergar
Resposta direta: Governança de sistemas legados é o conjunto de controles sobre quem acessa o sistema, do que ele depende e o que os seus dados significam. Em ambientes antigos, o obstáculo não é a política de governança, é a visibilidade: não se controla um acesso que ninguém mapeou, uma dependência que ninguém documentou nem um campo cujo significado se perdeu. A sequência correta é tornar visível antes de controlar. Na prática, isso apoia a governança de acesso e mudança em uma camada como o Jira e a governança de dados e linhagem em uma plataforma como o Databricks.
A maioria dos projetos de governança sobre sistemas legados começa pelo lugar errado. Define-se uma política de acesso, um comitê, um fluxo de aprovação, e só depois se descobre que ninguém sabe ao certo quais integrações consomem aquele banco, quem tem credencial ativa há sete anos ou o que a coluna STATUS_2 realmente representa. Governar pressupõe controlar, e controlar pressupõe conhecer. No legado, essa cadeia se rompe no primeiro elo.
Este artigo trata a governança do legado como um problema de visibilidade antes de tratá-la como um problema de política. Ele descreve os três pontos cegos que inviabilizam qualquer controle e mostra onde uma consultoria Jira e uma consultoria Databricks entram, cada uma iluminando uma parte do sistema que hoje está no escuro.
A tese deste artigo: Governança de sistemas legados não falha por falta de regra. Falha porque a regra é escrita sobre um sistema que ninguém enxerga por inteiro. Antes de definir quem pode o quê, é preciso responder três perguntas: quem acessa, do que depende, o que significa. Sem essas respostas, governança vira documento, não controle.
Por que a governança de sistemas legados costuma falhar?
A governança falha no legado quando é implantada como camada de política sobre um sistema opaco. O comitê aprova regras de acesso, mas a lista de quem tem acesso está incompleta. A norma exige rastrear mudanças, mas as mudanças acontecem por scripts diretos no banco. A LGPD pede saber onde estão os dados pessoais, mas ninguém consegue dizer por quais tabelas um CPF trafega. A regra existe; a capacidade de cumpri-la não.
O padrão é sempre o mesmo: a organização trata governança como decisão administrativa quando ela é, primeiro, um problema de engenharia da informação. Um sistema com vinte anos acumulou acessos que nunca foram revogados, integrações que nunca foram documentadas e significados que saíram junto com quem os conhecia. Governar isso exige, antes, enxergar isso.
Os três pontos cegos do legado
Todo sistema antigo sem governança tem três zonas escuras. Cada uma bloqueia um tipo de controle, e cada uma é iluminada por um instrumento diferente.
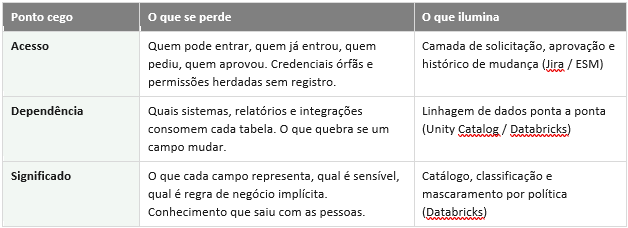
A ordem importa. Não dá para mascarar um dado sensível que você não classificou, e não dá para classificar um campo cujo significado ninguém conhece. A visibilidade é pré-requisito, não etapa paralela.
Como governar o acesso e a mudança no legado com Jira?
A governança de acesso e de mudança no legado se estrutura transformando pedidos informais em registros rastreáveis. Em vez de acesso concedido por mensagem e mudança feita direto no ambiente, cada solicitação vira um item com quem pediu, qual justificativa, quem aprovou e o que foi alterado. É o primeiro ponto cego, o do acesso, saindo do escuro.
Uma consultoria Jira atua aqui estruturando o fluxo antes da ferramenta. O Jira Service Management permite modelar solicitação de acesso, aprovação e trilha de mudança sobre sistemas que não têm governança nativa nenhuma. O que importa não é abrir chamado, é que toda concessão e toda alteração passem a existir como registro consultável: quem, quando, por quê, aprovado por quem. Fonte: documentação oficial do Atlassian Jira Service Management.
Há uma disciplina de configuração que essa camada exige, e ela também é governança. Campos personalizados sem controle viram o próprio caos que se queria evitar. A Atlassian passou a aplicar limites de campos personalizados por espaço no Jira Cloud a partir de março de 2026, com restrições adicionais anunciadas para setembro de 2026, justamente para conter a proliferação que degrada performance e governança. Governar o legado por uma camada mal governada apenas move o problema.
Quando o Jira resolve, e quando não: O Jira ilumina e controla o acesso e a mudança: quem entra, quem muda, com que autorização. Ele não enxerga o que acontece dentro do banco de dados legado, quais tabelas uma integração lê ou o que um campo significa. Para o ponto cego da dependência e do significado, a camada é outra.
Como enxergar dependência e significado dos dados legados com Databricks?
A dependência e o significado dos dados legados ficam visíveis quando os dados passam por uma camada que registra linhagem e classificação. Linhagem responde do que cada tabela depende e o que quebra se ela mudar. Classificação e catálogo respondem o que cada campo é e qual é sensível. São o segundo e o terceiro pontos cegos saindo do escuro.
Uma consultoria Databricks atua sobre esses dois pontos. No Unity Catalog, a linhagem de dados é capturada automaticamente ao longo de consultas e pipelines, incluindo linhagem de fontes externas, o que permite reconstruir o mapa de dependências de um ambiente legado que nunca foi documentado. A partir daí, a governança deixa de ser adivinhação: dá para dizer quais relatórios e integrações consomem cada tabela antes de alterá-la.
Sobre o significado, o Unity Catalog permite classificar dados e aplicar máscaras de coluna e filtros de linha por política, além de controle de acesso baseado em atributos. Um campo classificado como sensível pode ser mascarado para quem não deve vê-lo sem reescrever o sistema legado que o produz. Isso conecta diretamente com a LGPD: os artigos 46 e 52 exigem medidas de segurança e responsabilizam o tratamento inadequado de dados pessoais, e você não protege o que não classificou.
O conector nativo entre as duas camadas
As duas frentes não ficam isoladas. O Lakeflow Connect, do Databricks, oferece um conector para dados do Jira, atualmente em Beta, que permite trazer os registros de acesso e mudança do Jira para o mesmo ambiente governado onde vive a linhagem dos dados. Fonte: documentação Databricks, Lakeflow Connect Jira connector. Na prática, isso significa cruzar quem mudou o quê com o que aquela mudança afeta, dentro de uma única camada de governança auditável.
Ressalva de maturidade: recursos em Beta não têm garantia de disponibilidade geral nem SLA de produção. A decisão de apoiar governança crítica sobre um conector Beta é uma escolha de arquitetura que precisa de plano de contingência, não um pressuposto.
Qual é a sequência para tornar o legado governável?
A sequência para governar o legado é tornar visível antes de controlar, e a visibilidade tem ordem: primeiro acesso e dependência, depois significado, só então política. Inverter isso produz o projeto de governança que gera documento e não muda comportamento.
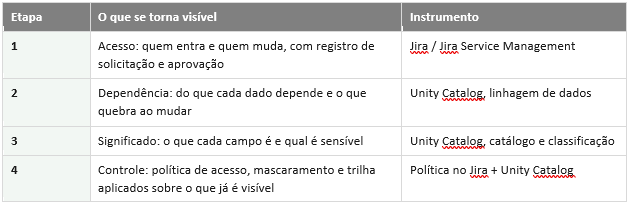
É aqui que o trabalho de uma consultoria se diferencia de uma implantação de ferramenta. Ferramenta instala rápido. A ordem certa, o desenho do fluxo e a leitura do que o legado esconde é o que a CSP Tech acumulou em 34 anos de projetos de dados e modernização, como Atlassian Gold e Microsoft Gold Partner. A autoridade está na sequência, não no software.
Quando essa abordagem não é a prioridade
• Sistema em fim de vida com desligamento decidido. Se o legado será desativado em poucos meses, investir em governança profunda dele é esforço mal alocado. Priorize a migração segura dos dados, não o controle do que vai morrer.
• Ambiente sem nenhum dado sensível ou regulado. Se não há dado pessoal, financeiro ou sujeito a norma, o custo de linhagem e mascaramento pode superar o risco. Governe na proporção do que está em jogo.
• Organização sem dono de governança definido. Visibilidade sem alguém responsável por agir sobre o que ela revela vira relatório ignorado. A camada técnica pressupõe uma decisão organizacional de que alguém responde por ela.
Próximo passo
Se você não consegue responder com segurança quem tem acesso ao seu sistema legado, do que ele depende e o que seus campos significam, o problema não é a sua política de governança. É a visibilidade que falta debaixo dela. Solicite um diagnóstico de visibilidade e governança do seu legado com a CSP Tech: mapeamos os três pontos cegos no seu ambiente e mostramos o que precisa ficar visível antes de qualquer controle.
Perguntas frequentes
O que é governança de sistemas legados?
É o conjunto de controles sobre quem acessa um sistema antigo, do que ele depende e o que seus dados significam. No legado, a dificuldade central não é definir a política de governança, é obter a visibilidade sem a qual nenhuma política pode ser cumprida: acessos não mapeados, dependências não documentadas e significados perdidos.
Por que começar governança de legado por visibilidade e não por política?
Porque controle pressupõe conhecimento. Uma política de acesso escrita sobre uma lista incompleta de usuários não controla nada, e uma exigência de rastrear mudanças não se cumpre se as mudanças acontecem fora de qualquer registro. Tornar visível quem acessa, do que depende e o que significa é pré-requisito para que a política tenha sobre o que agir.
Onde entra o Databricks na governança de dados legados?
O Databricks, via Unity Catalog, captura linhagem de dados de forma automática, o que reconstrói o mapa de dependências de um ambiente não documentado, e permite classificar dados e aplicar máscaras de coluna e filtros de linha por política. Isso ilumina os pontos cegos de dependência e de significado sem reescrever o sistema legado que produz os dados. Fonte: documentação Databricks Unity Catalog.
Onde entra o Jira na governança de sistemas legados?
O Jira, em especial o Jira Service Management, estrutura a governança de acesso e de mudança: transforma pedidos de acesso e alterações informais em registros com solicitante, justificativa, aprovador e trilha de mudança, mesmo sobre sistemas sem governança nativa. Ele controla o ponto cego do acesso; a dependência e o significado dos dados ficam com a camada de dados. Fonte: documentação Atlassian Jira Service Management (acesso em set/2026).
Autor
Por Guilherme Matos.
Revisão técnica por especialista de Dados e Atlassian da CSP Tech.
A CSP Tech é uma consultoria brasileira de tecnologia com 34 anos de mercado, Atlassian Gold e Microsoft Gold Partner, atuando em dados e BI, plataforma Atlassian, desenvolvimento e modernização de sistemas.
Fontes
• Databricks, documentação Unity Catalog: data lineage, column masks e row filters, attribute-based access control (ABAC), acesso em set/2026.
• Databricks, Lakeflow Connect: Jira connector (Beta), acesso em set/2026.
• Atlassian, documentação Jira Service Management, acesso em set/2026.
• Atlassian, notas de mudança de custom fields no Jira Cloud (limites por espaço, mar/2026 e set/2026).
• Brasil, Lei nº 13.709/2018 (LGPD), artigos 46 e 52.