Implementação de IA empresarial com governança: por que os controles precisam morar em um lugar só

Guilherme Matos • August 21, 2026

Implementar IA com governança significa garantir que cinco decisões sejam tomadas de forma consistente toda vez que a IA é usada: que dado ela pode acessar, quanto contexto recebe, qual modelo aciona e sob qual teto de custo, o que precisa ser validado antes do aceite e o que fica registrado. O erro estrutural mais comum é implementar essas cinco decisões dentro de cada ferramenta, uma a uma. Isso funciona enquanto existe uma ferramenta e desmorona quando aparece a segunda, porque cada adoção nova reabre todas as cinco. Uma camada de controle de IA é o padrão de arquitetura que concentra essas decisões num único ponto pelo qual as interações passam, mantendo a liberdade de ferramenta na ponta. É exatamente o mesmo raciocínio que levou empresas a centralizar a governança do dado num catálogo, aplicado agora ao uso de IA.


O padrão que se repete a cada ferramenta nova


A sequência é conhecida por quem acompanhou os últimos dois anos. A empresa adota um assistente de código e, depois de algum susto, monta um conjunto de regras: quem pode usar, o que não pode ser colado no contexto, que tipo de saída precisa de revisão. Leva semanas e fica razoável.


Três meses depois, um time adota outra ferramenta, porque resolve melhor um caso específico. As regras não vêm junto: elas foram implementadas na configuração da primeira. Alguém precisa reabrir a discussão sobre acesso, sobre o que pode ser enviado, sobre o que exige revisão, e reimplementar tudo no novo ambiente. Meses depois, chega um agente que executa ações, e a discussão recomeça pela terceira vez, agora com uma dimensão a mais. O resultado é uma governança permanentemente atrasada em relação ao uso real, e a distância entre as duas cresce, porque ferramenta nova aparece mais rápido do que política se reimplementa.


A tese deste guia: governança distribuída por ferramenta não escala, porque cada ferramenta nova reabre todas as decisões. O que escala é concentrar a decisão e distribuir a execução, de modo que adotar a próxima ferramenta seja uma questão de conectá-la a um ponto de controle que já existe, e não de reconstruir a política inteira. A empresa que já aceitou esse princípio para o dado, ao adotar um catálogo, tem pouca razão para recusá-lo no uso de IA.


O precedente que a empresa já aceitou: o catálogo de dados


Vale observar como esse mesmo problema foi resolvido na camada de dados, porque a solução já é consenso e ninguém a chama de burocracia. Ninguém defende, hoje, controlar acesso a dado configurando permissão dentro de cada ferramenta de consulta, de cada notebook e de cada relatório. A documentação da Databricks descreve o Unity Catalog exatamente como a camada unificada de governança para dados e IA, reunindo controle de acesso, linhagem, auditoria e descoberta de forma centralizada. E há um detalhe dessa descrição que costuma passar despercebido e que é a ponte deste artigo: as mesmas permissões valem para pessoas, notebooks e modelos.


Ou seja, no plano do dado, a empresa já concentrou a decisão em um ponto e deixou a execução distribuída pelas ferramentas que consomem. Quem chega novo se conecta ao catálogo e herda a política. A pergunta que este artigo faz é por que a mesma empresa aceita que a governança do uso de IA continue espalhada, sendo reimplementada a cada adoção.

As cinco decisões e o que muda quando elas se concentram
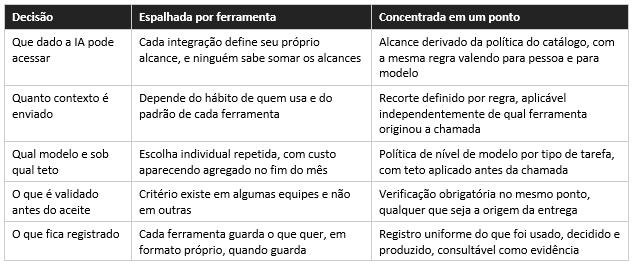
A coluna do meio explica por que auditoria de IA costuma ser dolorosa: a evidência existe fragmentada em formatos diferentes, e reuni-la é um projeto por si só. A coluna da direita explica por que a concentração compensa mesmo antes de qualquer exigência regulatória: ela é o que permite responder perguntas simples de gestão, como quanto custou determinada iniciativa ou que decisões automatizadas afetaram um cliente específico.

O que essa camada deve fazer, e o que ela não pode fazer


O maior risco desse desenho é virar gargalo. Se a concentração de decisão implicar que quem trabalha precise mudar de ferramenta, pedir autorização a cada tarefa ou esperar aprovação para o trivial, o resultado previsível é o contorno: as pessoas voltam a usar o caminho direto, e a governança passa a existir apenas no que foi declarado.


O desenho que funciona respeita três limites.


•     A ferramenta da ponta continua sendo escolha de quem trabalha. A camada de controle governa a interação, não a interface. Quem desenvolve continua no ambiente que prefere, e a política se aplica no caminho, não na porta.


•     A rotina passa sem fricção. A grande maioria das chamadas segue o padrão do seu tipo automaticamente. Só o que foge do padrão encontra barreira, e essa distinção é o que separa controle de burocracia.


•     O registro é subproduto, não tarefa. Se alguém precisa preencher algo para que a interação fique registrada, o registro será incompleto. Evidência confiável é a que se produz sozinha.


Descrito como fluxo, o padrão é este:


ferramenta escolhida por quem trabalha → ponto de controle →

política de dado e contexto → escolha de modelo e teto →

execução → validação contra critério → registro


Duas referências sustentam por que esse desenho é o que torna os controles efetivos, e não apenas elegantes. O Gartner recomenda, entre as ações para líderes de engenharia, introduzir limites de tokens, políticas de escalonamento e monitoramento automatizado, embutindo esses controles nos fluxos de engenharia justamente para garantir consistência e evitar crescimento descontrolado de custo. E o OWASP, ao tratar de autonomia excessiva em aplicações com IA, recomenda acesso de menor privilégio para todas as capacidades do modelo e supervisão humana em operações de alto impacto. Nenhuma dessas mitigações é aplicável de forma consistente se cada ferramenta tiver a sua própria interpretação delas.


Onde cada controle se ancora na arquitetura que a empresa já tem


Concentrar decisão não significa construir tudo do zero. Boa parte dos controles se ancora em plataformas que a empresa já opera, desde que sejam usadas como fonte de política, e não como configuração isolada.


O dado: o catálogo como fonte da política de acesso


A regra sobre o que a IA pode acessar não deveria ser escrita duas vezes. Se o catálogo já governa acesso, linhagem e auditoria, com as mesmas permissões valendo para pessoas, notebooks e modelos, ele é a fonte natural dessa política. Para dado sensível, os controles de granularidade fina aplicados no momento da consulta, como máscaras de coluna e filtros de linha, garantem que o tratamento aconteça independentemente de quem consulta, o que é precisamente a propriedade que se busca quando o consumidor pode ser um agente.


A decisão e a exceção: o fluxo de trabalho como registro


Política concentrada precisa de um lugar onde ser decidida, revisada e excepcionada com rastro. Na prática, isso significa tratar a decisão de política como item com dono e data de revisão, e a exceção como requisição com solicitante, justificativa, aprovador e prazo de resposta. No Jira e no Jira Service Management, isso é configuração deliberada de tipos de item, fluxo de aprovação e histórico de transições. Sem esse lugar, a política concentrada vira documento concentrado, que é diferente.


A qualidade: o portão de aceite como verificação obrigatória


A validação antes do aceite é o controle que mais se beneficia da concentração, porque é o único que impede o defeito de chegar em produção. Quando a verificação acontece no mesmo ponto independentemente de a entrega ter sido produzida por pessoa ou assistida por IA, o critério deixa de depender de qual time adotou a prática. Tratamos do desenho desse portão em artigo próprio sobre critérios de aceite.


Por que isso é decisão de arquitetura e não de ferramenta: concentrar controle exige entender simultaneamente como o dado é governado, onde a decisão fica registrada, o que caracteriza uma entrega aceitável e como tudo isso se aplica sem travar quem trabalha. São quatro competências que costumam morar em áreas distintas, e um desenho conduzido por uma delas sozinha produz controle que as outras contornam. A CSP Tech atua nas quatro frentes, como especialistas Databricks na camada de dado governado, com consultoria Jira como Atlassian Gold Partner na camada de decisão registrada, Microsoft Gold Partner na leitura executiva e 34 anos de engenharia de software na definição do que é entrega aceitável.


Sinais de que a sua governança está espalhada


•     A adoção de uma ferramenta nova de IA leva semanas de discussão de política. Se cada adoção reabre as mesmas conversas, a política está implementada nas ferramentas, e não acima delas.


•     Ninguém consegue somar o alcance de acesso das integrações existentes. Alcance que não se soma é alcance que não se governa.


•     Responder o que a IA fez em determinado período exige consultar várias fontes. Evidência fragmentada é o sintoma mais claro de controle disperso, e aparece justamente quando há menos tempo para reuni-la.


•     Times diferentes seguem regras diferentes sem que isso tenha sido decidido. Divergência não decidida é o efeito natural de política que mora na configuração de cada ambiente.


Quando não vale construir essa camada


•     Uma ferramenta, um time, uso de baixo impacto. Com um único ponto de uso, concentrar não traz ganho, porque não há dispersão a resolver. O momento é quando a segunda ferramenta aparece.


•     Antes de existir inventário do uso atual. Concentrar controle sobre um mapa incompleto produz um ponto de controle que governa parte do uso e ignora o resto, o que é pior que não ter, porque gera falsa segurança.


•     Se o desenho proposto obriga a trocar as ferramentas da ponta. Um controle que exige mudar o modo de trabalhar será contornado. Se essa é a única opção disponível, é melhor adiar e reavaliar o desenho.


Perguntas frequentes


O que é implementação de IA empresarial com governança?

É implementar IA garantindo que cinco decisões sejam tomadas de forma consistente em todo uso: que dado a IA pode acessar, quanto contexto recebe, qual modelo aciona e sob qual teto de custo, o que é validado antes do aceite e o que fica registrado como evidência. Governança, aqui, não é um documento que descreve essas decisões, é o mecanismo que as aplica de forma uniforme independentemente da ferramenta usada.


Por que não configurar os controles de IA dentro de cada ferramenta?

Porque não escala. Cada ferramenta nova reabre todas as decisões, e ferramentas novas aparecem mais rápido do que políticas se reimplementam, o que mantém a governança permanentemente atrasada em relação ao uso real. Além disso, a evidência fica fragmentada em formatos diferentes, e reuni-la vira um projeto no momento em que há menos tempo para isso. É o mesmo motivo pelo qual empresas pararam de controlar acesso a dado dentro de cada ferramenta de consulta e passaram a usar um catálogo.


O que é uma camada de controle de IA?

É o padrão de arquitetura em que as decisões de governança do uso de IA são concentradas num ponto pelo qual as interações passam, enquanto a escolha de ferramenta permanece livre na ponta. Ela aplica a política de dado e contexto, a escolha de modelo e teto de custo, a validação contra critério e o registro do que aconteceu. O requisito de projeto mais importante é não virar gargalo: a rotina passa sem fricção e só a exceção encontra barreira.


Como aplicar a mesma política em várias ferramentas de IA?

Definindo a política acima das ferramentas e ancorando cada controle onde ele já tem fonte natural: a política de acesso derivada do catálogo de dados, que aplica as mesmas permissões a pessoas, notebooks e modelos; a decisão e a exceção registradas no sistema onde o trabalho é acompanhado; e a verificação de qualidade no portão de aceite. Assim, conectar uma ferramenta nova passa a ser integrá-la a controles existentes, em vez de reimplementar a política inteira.


Próximo passo


Se a sua empresa já usa mais de uma ferramenta de IA e cada nova adoção reabre as mesmas discussões de política, o problema não é a próxima ferramenta: é que a governança foi implementada dentro delas em vez de acima delas. Solicite um diagnóstico de arquitetura de governança de IA com a CSP Tech e receba o mapa do seu ambiente: onde a IA já é usada, quais das cinco decisões estão dispersas hoje, onde cada controle pode se ancorar no que você já opera e em que ordem concentrar.


Autor: Guilherme Matos, estrategista de conteúdo e IA, certificado HubSpot, Google, Anthropic e Semrush. Revisão técnica por especialistas de dados e Atlassian da CSP Tech (parceira Databricks, Atlassian Gold Partner, Microsoft Gold Partner, participante do Anthropic Partner Network, 34 anos de mercado).


Fontes (oficiais, acesso ago/2026): Databricks Documentation (docs.databricks.com), quanto ao Unity Catalog como camada unificada de governança para dados e IA, com controle de acesso, linhagem, auditoria e descoberta centralizados e as mesmas permissões aplicáveis a pessoas, notebooks e modelos, e quanto a máscaras de coluna e filtros de linha aplicados no momento da consulta. Gartner, press release sobre consumo de tokens e custos de AI coding (gartner.com/en/newsroom, 24/jun/2026), quanto à recomendação de introduzir limites, políticas de escalonamento e monitoramento automatizado embutidos nos fluxos de engenharia para garantir consistência, mantida como recomendação atribuída. OWASP GenAI Security Project, Top 10 for LLM Applications 2025 (owasp.org), quanto às mitigações de menor privilégio para todas as capacidades do modelo e supervisão humana em operações de alto impacto. ISO, plataforma oficial de normas, ISO/IEC 42001:2023 (iso.org/obp), quanto ao requisito de atribuição de responsabilidades e retenção de informação documentada no sistema de gestão de IA. Atlassian, documentação de Jira e Jira Service Management sobre tipos de item, fluxo de aprovação e histórico de transições (atlassian.com). Este conteúdo descreve um padrão de arquitetura, não constitui recomendação de produto específico nem aconselhamento jurídico.
Fale com a CSP Tech

.

Por Guilherme Matos • 19 de novembro de 2026
Para usar agentes de IA sobre dados de sinistro sem expor dado pessoal do segurado, o agente precisa herdar a mesma regra de acesso do analista que faz a pergunta, aplicada no momento da consulta. No Databricks, isso depende de duas escolhas. A primeira é o modo de autorização do agente: na autorização por usuário , o agente consulta os dados com a identidade de quem pergunta, e o Unity Catalog aplica automaticamente filtros de linha e máscaras de coluna; na autorização do app, todos os usuários compartilham as permissões de uma conta técnica. A segunda é não contornar as máscaras com cópias de dados feitas para alimentar a busca vetorial. Em sinistros de vida, saúde e acidentes pessoais, parte desses dados é dado de saúde, que a LGPD trata como dado pessoal sensível. Por que o dado de sinistro pede um cuidado diferente Um processo de sinistro reúne dados de identificação do segurado e dos beneficiários, dados bancários para indenização, relatos do evento e, em vários ramos, laudos e informações médicas. A Lei Geral de Proteção de Dados define, no artigo 5º, inciso II, o dado referente à saúde como dado pessoal sensível, e o artigo 11 limita as hipóteses em que ele pode ser tratado. Entre elas estão o exercício regular de direitos, inclusive em contrato, e a garantia da prevenção à fraude. O artigo 6º, inciso III, acrescenta o princípio da necessidade: o tratamento deve se limitar ao mínimo necessário para a sua finalidade. Na operação, esse princípio já costuma estar refletido em perfis de acesso. O regulador de sinistro vê o processo que conduz, o time antifraude vê os sinais de que precisa, e o atendimento vê o status do pedido sem acessar o laudo. O risco do agente de IA é desfazer essa separação sem que ninguém perceba, porque ele responde em linguagem natural e não mostra de qual tabela, com qual permissão, tirou cada informação. Tese da CSP Tech: na seguradora, o agente de IA deve ver exatamente o que o analista que fez a pergunta veria, nem mais nem menos, e essa regra precisa ser aplicada no momento da consulta, pela plataforma de dados, e não por instruções no prompt. No Databricks, os dois pontos em que o dado do segurado costuma escapar são a escolha da autorização do agente e as cópias feitas para busca vetorial, e ambos se resolvem no desenho, antes do piloto. Os dois modos de autorização do agente Autorização do app Segundo a documentação da Databricks, atualizada em 23 de outubro de 2026, na autorização do app o agente se autentica com uma conta técnica criada automaticamente, e todos os usuários compartilham as mesmas permissões. É o modo mais simples de colocar um piloto no ar, e por isso é o mais comum. O efeito em um ambiente de sinistros é direto: se a conta técnica tem acesso ao laudo médico, qualquer pessoa que converse com o agente pode receber uma resposta baseada nele, ainda que o perfil dessa pessoa não permita abrir o laudo. Autorização por usuário Na autorização por usuário, antes chamada de on-behalf-of-user, o agente acessa os recursos com a identidade de quem faz a pergunta. A documentação lista como benefícios o acesso por usuário a dados sensíveis, os controles granulares do Unity Catalog, a trilha de auditoria por usuário e a aplicação automática de filtros de linha e máscaras de coluna. O recurso funciona com SQL Warehouse, Genie, Model Serving, índices de AI Search e tabelas do Unity Catalog, entre outros. Os dois modos podem ser combinados no mesmo agente, o que permite usar a conta técnica para recursos sem dado pessoal e a identidade do usuário para os que têm. Há três cuidados registrados pela própria Databricks. A autorização por usuário está em prévia pública e precisa ser habilitada por um administrador do workspace. As mudanças de escopo podem levar até cinco minutos para valer, por causa de caches. E, se o token do usuário não chegar ao agente, a função que deveria usar a identidade dele recorre à conta técnica sem gerar erro. Por isso a documentação recomenda testar o agente com uma ferramenta que devolva a identidade em uso antes de liberar o acesso. Filtros de linha e máscaras de coluna: a regra aplicada na consulta No Unity Catalog, filtros de linha e máscaras de coluna restringem, no momento da consulta, quais linhas e quais valores cada usuário consegue ver, segundo a documentação de filtros e máscaras , atualizada em 6 de novembro de 2026. O filtro de linha é uma função que exclui as linhas para as quais retorna falso, o que permite, por exemplo, que o regulador veja só os processos da sua carteira. A máscara de coluna é uma função que devolve o valor original ou uma versão mascarada, o que permite mostrar o diagnóstico ao time médico e um valor oculto ao atendimento. Para aplicar a mesma regra a muitas tabelas, a Databricks recomenda políticas baseadas em atributos, ligadas a tags no catálogo ou no esquema, que os donos das tabelas não conseguem remover. Combinadas com a autorização por usuário, essas regras fazem o agente herdar o perfil do analista sem nenhuma instrução no prompt. Uma instrução do tipo “não revele dados de saúde” pode ser contornada por uma pergunta bem formulada, enquanto a máscara aplicada pela plataforma impede que o dado chegue ao modelo. Onde o dado do segurado escapa A cópia para busca vetorial. A documentação informa que tabelas com filtros de linha ou máscaras de coluna não podem ser usadas para criar um índice do AI Search. Quando o time de dados quer que o agente pesquise documentos de sinistro, a saída mais rápida é criar uma cópia sem as proteções para indexar, e com isso o índice passa a conter o que as máscaras escondiam. O desenho seguro prepara uma tabela própria para o índice, já sem os campos sensíveis ou com eles transformados, e aplica a autorização por usuário ao índice. Os clones e as versões antigas. Clones de tabelas com filtros ou máscaras não são suportados, e a consulta a versões anteriores da tabela, o time travel, não funciona com filtros e máscaras em nível de tabela. Ambientes de teste montados com cópias de produção são um caminho conhecido para o dado sensível sair do perímetro. As views. Filtros e máscaras não podem ser aplicados diretamente a uma view. Se o agente consulta uma view construída sobre a tabela original, a proteção precisa estar na tabela de origem. O fallback silencioso. Quando o token do usuário não chega ao agente, a consulta passa a usar a conta técnica sem erro. O teste de identidade em uso precisa fazer parte da homologação e do monitoramento, e não só do primeiro deploy. O que a seguradora precisa decidir antes do piloto A plataforma aplica as regras, mas não as define. Antes de liberar o agente, a seguradora precisa classificar quais colunas de sinistro são dado pessoal e quais são dado de saúde, decidir quais perfis podem ver cada classe, registrar essas decisões como tags governadas no catálogo e escolher, recurso por recurso, se o agente usa a identidade do usuário ou a conta técnica. Essa classificação é o mesmo trabalho de governança de dados que a seguradora já precisaria fazer para a LGPD, agora aplicado a um consumidor novo, que responde a perguntas em vez de abrir telas. O caso de dados de conversa, com mascaramento de gravações e transcrições, está tratado no artigo “Governança de dados de conversa no Databricks” , publicado no blog. Aqui o foco é o agente que consulta o processo de sinistro. A camada regulatória, com a ressalva devida A LGPD exige, no artigo 46, medidas de segurança técnicas e administrativas aptas a proteger os dados pessoais de acessos não autorizados, e não prescreve ferramenta. No mercado de seguros, a Circular Susep 638/2021 trata de segurança cibernética e determina a comunicação de incidentes relevantes à autarquia. A leitura de que o agente de IA deve herdar a regra de acesso do analista é uma interpretação editorial da CSP Tech sobre como aplicar o princípio da necessidade a um novo tipo de consumidor de dados. A base legal de cada tratamento, a classificação dos dados e a avaliação de impacto cabem ao encarregado de dados e às áreas de compliance e jurídico da seguradora. Quando esse desenho é desproporcional Um agente que trabalha só com dados agregados ou anonimizados, como volume de sinistros por ramo e região, não precisa de autorização por usuário: a conta técnica com acesso apenas a essas tabelas resolve. O mesmo vale para um agente interno que responde sobre normas e procedimentos, sem acesso a processos de segurados. O cuidado descrito aqui é para o agente que consulta processos individuais. Perguntas frequentes Dado de sinistro é dado pessoal sensível? Parte dele é. A LGPD, no artigo 5º, inciso II, classifica o dado referente à saúde como dado pessoal sensível, e processos de sinistro de vida, saúde e acidentes pessoais costumam conter laudos e informações médicas. Dados de identificação e bancários do segurado são dados pessoais, ainda que não sensíveis. O que é autorização por usuário em agentes do Databricks? É o modo em que o agente acessa os dados com a identidade de quem faz a pergunta, antes chamado de on-behalf-of-user. Com ele, o Unity Catalog aplica automaticamente filtros de linha e máscaras de coluna. Segundo a documentação da Databricks de outubro de 2026, o recurso está em prévia pública e precisa ser habilitado por um administrador do workspace. Posso indexar no AI Search uma tabela com máscaras de coluna? Não. A documentação da Databricks informa que tabelas com filtros de linha ou máscaras de coluna não podem ser usadas para criar um índice do AI Search. O caminho seguro é preparar uma tabela própria para o índice, sem os campos sensíveis ou com eles transformados, em vez de copiar a tabela original sem proteção. Uma instrução no prompt basta para o agente não revelar dados de saúde? Não é uma proteção confiável, porque pode ser contornada por perguntas bem formuladas. A forma mais segura é impedir que o dado chegue ao modelo, aplicando máscaras de coluna e filtros de linha na plataforma de dados e fazendo o agente consultar com a identidade do usuário. Próximo passo Faça um teste de dez minutos: no agente que sua equipe está testando sobre dados de sinistro, faça a mesma pergunta com dois usuários de perfis diferentes, um do atendimento e outro da regulação, e compare as respostas. Depois, verifique se o índice de busca do agente foi criado a partir de uma cópia da tabela original. Se as respostas forem iguais, ou se o índice veio de uma cópia sem máscaras, o agente está vendo mais do que o analista. Solicite um diagnóstico de dados da CSP Tech para desenhar a autorização e as máscaras antes de ampliar o piloto. Leituras relacionadas Governança de dados e IA Segurança de agentes de IA: por que permissão virou o novo perímetro (e como limitar o agente sem inutilizá-lo) Data lake ou pântano de dados: por que a IA não fracassa por falta de dado, e sim por não achar o dado certo MDM no Databricks: como construir gestão de dados mestres no Lakehouse (sem comprar mais uma plataforma) Por que 40% dos projetos de agentes de IA serão cancelados até 2027 (e o que a fundação de dados tem a ver com isso) Setor financeiro e seguros Agentes de IA não autorizados chegaram às contas bancárias dos EUA. Seus sistemas sabem quem está do outro lado? Empresa de intranet para banco, cooperativa ou seguradora: como comparar plataforma pronta, SharePoint e desenvolvimento sob medida “De onde veio esse número”? Rastreabilidade de dados para decisões mais confiáveis Autor: Guilherme Matos, estrategista de conteúdo e IA, certificado HubSpot, Google, Anthropic e Semrush. Revisão técnica por especialistas Atlassian e de dados da CSP Tech (Atlassian Gold Partner, parceira Databricks, Microsoft Gold Partner, participante do Anthropic Partner Network, 38 anos de mercado, produto próprio Power BI for Jira no Atlassian Marketplace). Fontes (acesso em 19/11/2026): Databricks Documentation, “Authentication for AI agents” (autorização do app e por usuário; prévia pública; fallback sem erro; recursos suportados), atualizada em 23/10/2026. Databricks Documentation, “Row filters and column masks” (avaliação em tempo de consulta, políticas ABAC, limitações com AI Search, clones, time travel e views), atualizada em 06/11/2026. Lei nº 13.709/2018 (LGPD) , arts. 5º (II), 6º (III), 11 e 46, texto compilado no Planalto. Circular Susep nº 638/2021 . A tese e as práticas de desenho são formulação editorial da CSP Tech. Este conteúdo não constitui aconselhamento jurídico ou regulatório.
Por Guilherme Matos • 18 de novembro de 2026
Scripts envenenados em quatro serviços web, DDoS contra a rede Tor: como cada ataque de novembro de 2026 funcionou e o que revisar em cada camada.
Por Guilherme Matos • 17 de novembro de 2026
Com o Pix funcionando 24 horas, a mudança segura em pagamentos é a que chega à janela com o caminho de volta testado e registrado. Veja como estruturar janela, aprovação e rollback.
Por Guilherme Matos • 16 de novembro de 2026
A linhagem do Unity Catalog mostra de onde veio cada coluna, mas tem limites documentados. Veja o que ela não cobre e o que a instituição financeira precisa somar para defender um número reportado.
Por Guilherme Matos • 13 de novembro de 2026
Em banco, seguradora ou cooperativa, um normativo interno vencido que continua acessível na intranet deixa de ser só conteúdo desatualizado e passa a ser instrução operacional errada. Com o Microsoft 365 Copilot, o risco cresce, porque o assistente usa todo o conteúdo que o colaborador tem permissão de ver, inclusive a
Por Guilherme Matos • 12 de novembro de 2026
Uma instância Jira por cooperativa ou uma para o sistema inteiro? Veja os três desenhos possíveis, os critérios de decisão e o que a Resolução 4.893 permite ao sistema cooperativo.
Por Guilherme Matos • 10 de novembro de 2026
Com IA, o gestor de banco pergunta ao dado em linguagem natural em vez de esperar o relatório. Veja o que muda no time de dados com o Genie do Databricks: curadoria, testes de precisão, revisão de respostas e o histórico de perguntas como fila de demanda.
Por Guilherme Matos • 9 de novembro de 2026
Banco, cooperativa e seguradora já usam mais IA do que a TI registrou. Veja o que um inventário de IA precisa conter para servir de evidência à auditoria e ao Banco Central, de onde vêm os itens e onde manter o registro vivo no Jira Service.
Por Guilherme Matos • 5 de novembro de 2026
A Resolução 4.893 pede que o Banco Central saiba onde os dados podem ser processados. No Databricks, os recursos de IA seguem a área geográfica do workspace, que pode ir além do Brasil. Veja o que mapear antes de contratar e como configurar.