IA em projetos de sistemas legados: por que ela acelera o código e pode travar a entrega, e o que governa a diferença

Guilherme Matos • October 6, 2026

Em projeto de modernização de sistemas legados, a IA tende a acelerar o programador e, ao mesmo tempo, pressionar a entrega para baixo. O relatório DORA 2024, do Google Cloud, mediu que um aumento de 25% na adoção de IA veio acompanhado de cerca de 2,1% de ganho de produtividade individual, mas também de 1,5% de queda no throughput de entrega e de 7,2% de queda na estabilidade, porque a IA leva a mudanças maiores e mais arriscadas por ciclo.


No legado, onde o contexto é o menos governado de todos, esse efeito é amplificado. O que decide se a IA acelera o projeto ou acelera o erro são duas camadas de governança: o especialista Jira, que governa a entrega da mudança como registro auditável, e a governança de dados, que governa o que a IA e as pessoas alcançam no dado legado.

O sprint que entregou o dobro e quebrou em produção


A cena ficou comum desde que a IA entrou no fluxo de desenvolvimento. Um time adota um assistente de código, a velocidade aparente sobe, o volume de pull requests dobra e a sensação no sprint é de aceleração real. Todo mundo está produzindo mais, e os números individuais confirmam.


Semanas depois, a conta chega do outro lado. A taxa de falha de implantação subiu, um incidente em produção tomou dias para ser diagnosticado e a mudança que o causou era grande demais para ser revisada com atenção. O ganho que apareceu no indivíduo foi devolvido, com juros, na entrega. É exatamente o padrão que o DORA 2024 descreve: mais adoção de IA, mais produtividade percebida e menos estabilidade de entrega, porque a IA facilita mudanças maiores que o processo de revisão não acompanha.


A tese deste guia: num projeto de legado, a IA não decide o resultado, a governança do contexto decide. A IA amplifica o que o projeto já é. Projeto com entrega governada e dado governado recebe aceleração; projeto sem essas duas camadas recebe a mesma aceleração aplicada ao erro, e no legado, onde o contexto é o mais impreciso, o erro é o resultado mais provável.


O que os dados de alta credibilidade dizem sobre IA na entrega?


A evidência pública mais sólida sobre o efeito da IA na entrega de software aponta para a mesma direção: ganho no indivíduo, risco na entrega, e um efeito muito sensível ao contexto e à medição. A tabela reúne os números com a fonte e a data de cada um.
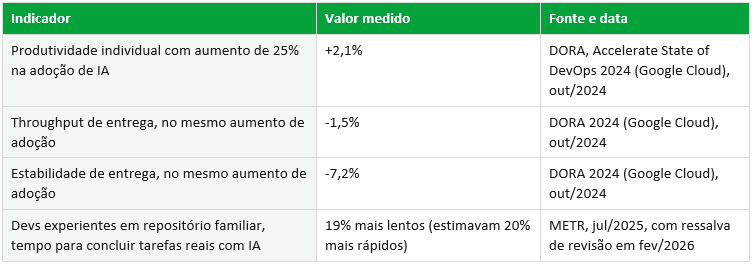
A linha da METR exige honestidade, e ela reforça a tese em vez de enfraquecê-la. No estudo de julho de 2025, desenvolvedores experientes levaram 19% mais tempo para concluir tarefas em repositórios que já conheciam quando usaram IA, embora estimassem ter ficado 20% mais rápidos. Em fevereiro de 2026 a própria METR sinalizou que esse número pode estar desatualizado, que ganhos passaram a ser prováveis e que o novo desenho do estudo ainda não permite medir o tamanho do efeito com confiança. O ponto que sobrevive à revisão não é o número, é o fenômeno: o efeito da IA na entrega depende do contexto e é difícil de medir, e a percepção de ganho não é prova de ganho.

Por que o legado amplifica esse efeito?


O legado amplifica porque é o ambiente onde o contexto está mais impreciso, e IA aplicada a contexto impreciso produz mudança confiante e errada. Num sistema novo, as relações que importam cabem no que o modelo e o time veem. Num sistema com vinte anos, as dependências estão implícitas, a documentação envelheceu e quem construiu saiu. A mesma IA que acelera uma mudança isolada produz, no legado, a alteração que parece certa e quebra outra coisa, que é o erro mais caro porque não avisa.


O mecanismo do DORA se encaixa aqui com precisão: se a IA leva a mudanças maiores e a estabilidade cai por isso, o legado é onde a mudança grande é mais perigosa, porque é onde menos se sabe o que ela afeta. Acelerar a produção de código sobre um legado mal governado é aumentar o tamanho e a frequência das mudanças no exato lugar onde o impacto delas é menos visível.


O papel do especialista Jira: governar a entrega da mudança


A primeira camada que decide o resultado é a governança da entrega, e ela mora no registro do projeto. Um especialista Jira desenha a instância para que a mudança gerada com IA não entre em produção como um grande bloco opaco, e sim como item rastreável com tamanho controlado, análise de impacto, aprovação e histórico. É a resposta direta ao mecanismo do DORA: se a queda de estabilidade vem do tamanho da mudança, governar o tamanho e a revisão da mudança é o controle.


Na prática, isso significa tratar a entrega assistida por IA com os mesmos instrumentos de governança de qualquer entrega crítica. O Jira e o Jira Service Management oferecem tipos de item, campos, fluxo de aprovação e histórico de transições para registrar o que foi alterado, por quem, com qual justificativa e com qual verificação de impacto antes do merge. Vale lembrar que essa camada também precisa de disciplina própria: a Atlassian passou a aplicar limites de campos personalizados por espaço no Jira Cloud a partir de março de 2026, com restrições adicionais em setembro de 2026, e uma instância que vira ruído não governa coisa alguma. Fonte: documentação Atlassian, Jira e Jira Service Management, e notas de campos personalizados do Jira Cloud.


O papel da governança de dados: governar o que a IA alcança no legado


A segunda camada é a governança de dados, e ela decide o que a IA consegue ler e tocar no legado. Um agente ou um assistente herda o alcance da credencial que recebe, não a intenção de quem o aciona. Sem governança de dados, acelerar o desenvolvimento com IA sobre o legado é dar velocidade a um acesso que ninguém delimitou.


A documentação da Databricks descreve o Unity Catalog aplicando as mesmas permissões a pessoas, notebooks e modelos, com controle de acesso, linhagem e auditoria centralizados, e com máscaras de coluna e filtros de linha aplicados no momento da consulta, de forma que o tratamento de dado sensível independa de quem, ou do que, consulta. A linhagem, capturada automaticamente até o nível de coluna, responde de que o legado depende antes de qualquer mudança assistida por IA. Isso conecta direto com a LGPD, cujos artigos 46 e 52 exigem medidas de segurança e responsabilizam o tratamento inadequado de dado pessoal.


A leitura que amarra as duas camadas é editorial da CSP Tech, construída a partir do dado público do DORA e das capacidades documentadas da Atlassian e da Databricks, e não um modelo oficial de nenhuma das três. O ponto é que as duas governanças respondem a lados diferentes do mesmo risco: o especialista Jira governa a entrega da mudança, a governança de dados governa o alcance da mudança no dado, e a IA no projeto de legado só acelera valor quando as duas existem.


Quando a IA no projeto de legado rende sem esse rigor


•  Prova de conceito isolada, fora de produção. Em experimento que não toca o sistema real nem o dado sensível, a IA pode acelerar exploração sem o peso da governança completa. O rigor entra quando aquilo vira caminho para produção.

•  Módulo novo e desacoplado dentro do projeto. Quando a parte em desenvolvimento não tem o emaranhado de dependências do legado, o contexto cabe no que o time vê, e o ganho da IA aparece com menos risco.

•  Time pequeno, com revisão forte e mudança pequena por padrão. Se a cultura já limita o tamanho da mudança e revisa com atenção, parte do efeito negativo do DORA é contido na origem, e a governança formal pode ser proporcional.


A regra é a de sempre: governe na proporção do risco. O argumento não é que IA em legado precisa de burocracia máxima, é que a aceleração sem as duas camadas de governança tende a aparecer como ganho no indivíduo e prejuízo na entrega, que é o oposto do que o projeto contratou.


Próximo passo


Há uma pergunta de dez minutos que separa projeto governado de projeto acelerado no escuro: nos últimos três meses, as mudanças geradas com apoio de IA no seu legado ficaram maiores ou menores, e a sua taxa de falha de implantação subiu ou caiu? Se a resposta for que as mudanças cresceram e a falha subiu, você está vivendo o efeito que o DORA mediu. Solicite um diagnóstico de governança do seu projeto de modernização com IA com a CSP Tech e receba a leitura das duas camadas no seu caso: como a entrega da mudança está governada no Jira e qual é o alcance real da IA sobre o seu dado legado.


Perguntas frequentes


A IA acelera projetos de modernização de sistemas legados?

Acelera a produção individual de código, mas o efeito na entrega do projeto depende de governança. O DORA 2024, do Google Cloud, mediu que um aumento de 25% na adoção de IA veio com cerca de 2,1% de ganho de produtividade individual, 1,5% de queda no throughput de entrega e 7,2% de queda na estabilidade, porque a IA leva a mudanças maiores e mais arriscadas. No legado, onde o contexto é o menos governado, esse efeito é amplificado, e sem governar entrega e dado a aceleração recai sobre o erro.


Qual o papel de um especialista Jira num projeto de legado com IA?

Governar a entrega da mudança. Um especialista Jira desenha a instância para que a mudança gerada com IA entre como item rastreável, com tamanho controlado, análise de impacto, aprovação e histórico, em vez de um grande bloco opaco. Como a queda de estabilidade medida pelo DORA vem do tamanho da mudança, governar o tamanho e a revisão da mudança no registro do projeto é o controle direto para esse risco.


Como a governança de dados se aplica à IA sobre sistema legado?

Ela governa o que a IA consegue ler e tocar no legado, já que um agente herda o alcance da credencial, não a intenção de quem o aciona. Com o Unity Catalog, do Databricks, as mesmas permissões se aplicam a pessoas, notebooks e modelos, com linhagem automática e máscaras aplicadas na consulta, de forma que o dado sensível seja tratado independentemente de quem consulta. Isso conecta com a LGPD, arts. 46 e 52. Fonte: documentação Databricks, acesso set/2026.


A IA deixa os desenvolvedores mais rápidos?

Depende do contexto, e a evidência é mais ambígua do que a percepção. Um estudo da METR de julho de 2025 encontrou desenvolvedores experientes 19% mais lentos com IA em repositórios familiares, mesmo estimando ter ficado 20% mais rápidos. Em fevereiro de 2026 a própria METR sinalizou que o número pode estar desatualizado e que ganhos passaram a ser prováveis, sem conseguir medir o tamanho com confiança. A conclusão robusta é que percepção de ganho não é prova de ganho, e medir a entrega continua necessário.

Autor: Guilherme Matos, estrategista de conteúdo e IA, certificado HubSpot, Google, Anthropic e Semrush. Revisão técnica por especialistas Atlassian e de dados da CSP Tech (Atlassian Gold Partner, parceira Databricks, Microsoft Gold Partner, participante do Anthropic Partner Network, 34 anos de mercado, produto próprio Power BI for Jira no Atlassian Marketplace).


Fontes (oficiais e de alta credibilidade, acesso out/2026): Google Cloud, DORA Accelerate State of DevOps Report 2024 (dora.dev), quanto ao achado de que um aumento de 25% na adoção de IA se associou a cerca de 2,1% de aumento de produtividade individual, 1,5% de redução no throughput de entrega e 7,2% de redução na estabilidade de entrega, com o mecanismo atribuído a mudanças maiores por ciclo. METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (metr.org, jul/2025), quanto ao achado de desenvolvedores experientes 19% mais lentos em repositórios familiares ao usar IA, com estimativa subjetiva de 20% mais rápidos, e atualização da METR de fevereiro de 2026 sinalizando que o resultado pode estar desatualizado e que o desenho do estudo está sob revisão. Atlassian, documentação do Jira e do Jira Service Management quanto a tipos de item, campos, fluxo de aprovação e histórico de transições, e notas do Jira Cloud quanto aos limites de campos personalizados por espaço aplicados a partir de março de 2026 com restrições adicionais em setembro de 2026 (atlassian.com). Databricks Documentation (docs.databricks.com), quanto ao Unity Catalog aplicando as mesmas permissões a pessoas, notebooks e modelos, com linhagem automática por coluna e máscaras aplicadas na consulta. Brasil, Lei nº 13.709/2018 (LGPD), artigos 46 e 52. A amarração das duas camadas de governança e a tese de amplificação no legado são formulação editorial da CSP Tech, construídas a partir das fontes acima, e não constituem norma ou padrão de mercado. Nenhum número foi citado sem fonte nomeada e datada. Este conteúdo trata de arquitetura e governança técnica e não constitui aconselhamento jurídico.
Fale com a CSP Tech

.

Por Guilherme Matos • 19 de novembro de 2026
Para usar agentes de IA sobre dados de sinistro sem expor dado pessoal do segurado, o agente precisa herdar a mesma regra de acesso do analista que faz a pergunta, aplicada no momento da consulta. No Databricks, isso depende de duas escolhas. A primeira é o modo de autorização do agente: na autorização por usuário , o agente consulta os dados com a identidade de quem pergunta, e o Unity Catalog aplica automaticamente filtros de linha e máscaras de coluna; na autorização do app, todos os usuários compartilham as permissões de uma conta técnica. A segunda é não contornar as máscaras com cópias de dados feitas para alimentar a busca vetorial. Em sinistros de vida, saúde e acidentes pessoais, parte desses dados é dado de saúde, que a LGPD trata como dado pessoal sensível. Por que o dado de sinistro pede um cuidado diferente Um processo de sinistro reúne dados de identificação do segurado e dos beneficiários, dados bancários para indenização, relatos do evento e, em vários ramos, laudos e informações médicas. A Lei Geral de Proteção de Dados define, no artigo 5º, inciso II, o dado referente à saúde como dado pessoal sensível, e o artigo 11 limita as hipóteses em que ele pode ser tratado. Entre elas estão o exercício regular de direitos, inclusive em contrato, e a garantia da prevenção à fraude. O artigo 6º, inciso III, acrescenta o princípio da necessidade: o tratamento deve se limitar ao mínimo necessário para a sua finalidade. Na operação, esse princípio já costuma estar refletido em perfis de acesso. O regulador de sinistro vê o processo que conduz, o time antifraude vê os sinais de que precisa, e o atendimento vê o status do pedido sem acessar o laudo. O risco do agente de IA é desfazer essa separação sem que ninguém perceba, porque ele responde em linguagem natural e não mostra de qual tabela, com qual permissão, tirou cada informação. Tese da CSP Tech: na seguradora, o agente de IA deve ver exatamente o que o analista que fez a pergunta veria, nem mais nem menos, e essa regra precisa ser aplicada no momento da consulta, pela plataforma de dados, e não por instruções no prompt. No Databricks, os dois pontos em que o dado do segurado costuma escapar são a escolha da autorização do agente e as cópias feitas para busca vetorial, e ambos se resolvem no desenho, antes do piloto. Os dois modos de autorização do agente Autorização do app Segundo a documentação da Databricks, atualizada em 23 de outubro de 2026, na autorização do app o agente se autentica com uma conta técnica criada automaticamente, e todos os usuários compartilham as mesmas permissões. É o modo mais simples de colocar um piloto no ar, e por isso é o mais comum. O efeito em um ambiente de sinistros é direto: se a conta técnica tem acesso ao laudo médico, qualquer pessoa que converse com o agente pode receber uma resposta baseada nele, ainda que o perfil dessa pessoa não permita abrir o laudo. Autorização por usuário Na autorização por usuário, antes chamada de on-behalf-of-user, o agente acessa os recursos com a identidade de quem faz a pergunta. A documentação lista como benefícios o acesso por usuário a dados sensíveis, os controles granulares do Unity Catalog, a trilha de auditoria por usuário e a aplicação automática de filtros de linha e máscaras de coluna. O recurso funciona com SQL Warehouse, Genie, Model Serving, índices de AI Search e tabelas do Unity Catalog, entre outros. Os dois modos podem ser combinados no mesmo agente, o que permite usar a conta técnica para recursos sem dado pessoal e a identidade do usuário para os que têm. Há três cuidados registrados pela própria Databricks. A autorização por usuário está em prévia pública e precisa ser habilitada por um administrador do workspace. As mudanças de escopo podem levar até cinco minutos para valer, por causa de caches. E, se o token do usuário não chegar ao agente, a função que deveria usar a identidade dele recorre à conta técnica sem gerar erro. Por isso a documentação recomenda testar o agente com uma ferramenta que devolva a identidade em uso antes de liberar o acesso. Filtros de linha e máscaras de coluna: a regra aplicada na consulta No Unity Catalog, filtros de linha e máscaras de coluna restringem, no momento da consulta, quais linhas e quais valores cada usuário consegue ver, segundo a documentação de filtros e máscaras , atualizada em 6 de novembro de 2026. O filtro de linha é uma função que exclui as linhas para as quais retorna falso, o que permite, por exemplo, que o regulador veja só os processos da sua carteira. A máscara de coluna é uma função que devolve o valor original ou uma versão mascarada, o que permite mostrar o diagnóstico ao time médico e um valor oculto ao atendimento. Para aplicar a mesma regra a muitas tabelas, a Databricks recomenda políticas baseadas em atributos, ligadas a tags no catálogo ou no esquema, que os donos das tabelas não conseguem remover. Combinadas com a autorização por usuário, essas regras fazem o agente herdar o perfil do analista sem nenhuma instrução no prompt. Uma instrução do tipo “não revele dados de saúde” pode ser contornada por uma pergunta bem formulada, enquanto a máscara aplicada pela plataforma impede que o dado chegue ao modelo. Onde o dado do segurado escapa A cópia para busca vetorial. A documentação informa que tabelas com filtros de linha ou máscaras de coluna não podem ser usadas para criar um índice do AI Search. Quando o time de dados quer que o agente pesquise documentos de sinistro, a saída mais rápida é criar uma cópia sem as proteções para indexar, e com isso o índice passa a conter o que as máscaras escondiam. O desenho seguro prepara uma tabela própria para o índice, já sem os campos sensíveis ou com eles transformados, e aplica a autorização por usuário ao índice. Os clones e as versões antigas. Clones de tabelas com filtros ou máscaras não são suportados, e a consulta a versões anteriores da tabela, o time travel, não funciona com filtros e máscaras em nível de tabela. Ambientes de teste montados com cópias de produção são um caminho conhecido para o dado sensível sair do perímetro. As views. Filtros e máscaras não podem ser aplicados diretamente a uma view. Se o agente consulta uma view construída sobre a tabela original, a proteção precisa estar na tabela de origem. O fallback silencioso. Quando o token do usuário não chega ao agente, a consulta passa a usar a conta técnica sem erro. O teste de identidade em uso precisa fazer parte da homologação e do monitoramento, e não só do primeiro deploy. O que a seguradora precisa decidir antes do piloto A plataforma aplica as regras, mas não as define. Antes de liberar o agente, a seguradora precisa classificar quais colunas de sinistro são dado pessoal e quais são dado de saúde, decidir quais perfis podem ver cada classe, registrar essas decisões como tags governadas no catálogo e escolher, recurso por recurso, se o agente usa a identidade do usuário ou a conta técnica. Essa classificação é o mesmo trabalho de governança de dados que a seguradora já precisaria fazer para a LGPD, agora aplicado a um consumidor novo, que responde a perguntas em vez de abrir telas. O caso de dados de conversa, com mascaramento de gravações e transcrições, está tratado no artigo “Governança de dados de conversa no Databricks” , publicado no blog. Aqui o foco é o agente que consulta o processo de sinistro. A camada regulatória, com a ressalva devida A LGPD exige, no artigo 46, medidas de segurança técnicas e administrativas aptas a proteger os dados pessoais de acessos não autorizados, e não prescreve ferramenta. No mercado de seguros, a Circular Susep 638/2021 trata de segurança cibernética e determina a comunicação de incidentes relevantes à autarquia. A leitura de que o agente de IA deve herdar a regra de acesso do analista é uma interpretação editorial da CSP Tech sobre como aplicar o princípio da necessidade a um novo tipo de consumidor de dados. A base legal de cada tratamento, a classificação dos dados e a avaliação de impacto cabem ao encarregado de dados e às áreas de compliance e jurídico da seguradora. Quando esse desenho é desproporcional Um agente que trabalha só com dados agregados ou anonimizados, como volume de sinistros por ramo e região, não precisa de autorização por usuário: a conta técnica com acesso apenas a essas tabelas resolve. O mesmo vale para um agente interno que responde sobre normas e procedimentos, sem acesso a processos de segurados. O cuidado descrito aqui é para o agente que consulta processos individuais. Perguntas frequentes Dado de sinistro é dado pessoal sensível? Parte dele é. A LGPD, no artigo 5º, inciso II, classifica o dado referente à saúde como dado pessoal sensível, e processos de sinistro de vida, saúde e acidentes pessoais costumam conter laudos e informações médicas. Dados de identificação e bancários do segurado são dados pessoais, ainda que não sensíveis. O que é autorização por usuário em agentes do Databricks? É o modo em que o agente acessa os dados com a identidade de quem faz a pergunta, antes chamado de on-behalf-of-user. Com ele, o Unity Catalog aplica automaticamente filtros de linha e máscaras de coluna. Segundo a documentação da Databricks de outubro de 2026, o recurso está em prévia pública e precisa ser habilitado por um administrador do workspace. Posso indexar no AI Search uma tabela com máscaras de coluna? Não. A documentação da Databricks informa que tabelas com filtros de linha ou máscaras de coluna não podem ser usadas para criar um índice do AI Search. O caminho seguro é preparar uma tabela própria para o índice, sem os campos sensíveis ou com eles transformados, em vez de copiar a tabela original sem proteção. Uma instrução no prompt basta para o agente não revelar dados de saúde? Não é uma proteção confiável, porque pode ser contornada por perguntas bem formuladas. A forma mais segura é impedir que o dado chegue ao modelo, aplicando máscaras de coluna e filtros de linha na plataforma de dados e fazendo o agente consultar com a identidade do usuário. Próximo passo Faça um teste de dez minutos: no agente que sua equipe está testando sobre dados de sinistro, faça a mesma pergunta com dois usuários de perfis diferentes, um do atendimento e outro da regulação, e compare as respostas. Depois, verifique se o índice de busca do agente foi criado a partir de uma cópia da tabela original. Se as respostas forem iguais, ou se o índice veio de uma cópia sem máscaras, o agente está vendo mais do que o analista. Solicite um diagnóstico de dados da CSP Tech para desenhar a autorização e as máscaras antes de ampliar o piloto. Leituras relacionadas Governança de dados e IA Segurança de agentes de IA: por que permissão virou o novo perímetro (e como limitar o agente sem inutilizá-lo) Data lake ou pântano de dados: por que a IA não fracassa por falta de dado, e sim por não achar o dado certo MDM no Databricks: como construir gestão de dados mestres no Lakehouse (sem comprar mais uma plataforma) Por que 40% dos projetos de agentes de IA serão cancelados até 2027 (e o que a fundação de dados tem a ver com isso) Setor financeiro e seguros Agentes de IA não autorizados chegaram às contas bancárias dos EUA. Seus sistemas sabem quem está do outro lado? Empresa de intranet para banco, cooperativa ou seguradora: como comparar plataforma pronta, SharePoint e desenvolvimento sob medida “De onde veio esse número”? Rastreabilidade de dados para decisões mais confiáveis Autor: Guilherme Matos, estrategista de conteúdo e IA, certificado HubSpot, Google, Anthropic e Semrush. Revisão técnica por especialistas Atlassian e de dados da CSP Tech (Atlassian Gold Partner, parceira Databricks, Microsoft Gold Partner, participante do Anthropic Partner Network, 38 anos de mercado, produto próprio Power BI for Jira no Atlassian Marketplace). Fontes (acesso em 19/11/2026): Databricks Documentation, “Authentication for AI agents” (autorização do app e por usuário; prévia pública; fallback sem erro; recursos suportados), atualizada em 23/10/2026. Databricks Documentation, “Row filters and column masks” (avaliação em tempo de consulta, políticas ABAC, limitações com AI Search, clones, time travel e views), atualizada em 06/11/2026. Lei nº 13.709/2018 (LGPD) , arts. 5º (II), 6º (III), 11 e 46, texto compilado no Planalto. Circular Susep nº 638/2021 . A tese e as práticas de desenho são formulação editorial da CSP Tech. Este conteúdo não constitui aconselhamento jurídico ou regulatório.
Por Guilherme Matos • 18 de novembro de 2026
Scripts envenenados em quatro serviços web, DDoS contra a rede Tor: como cada ataque de novembro de 2026 funcionou e o que revisar em cada camada.
Por Guilherme Matos • 17 de novembro de 2026
Com o Pix funcionando 24 horas, a mudança segura em pagamentos é a que chega à janela com o caminho de volta testado e registrado. Veja como estruturar janela, aprovação e rollback.
Por Guilherme Matos • 16 de novembro de 2026
A linhagem do Unity Catalog mostra de onde veio cada coluna, mas tem limites documentados. Veja o que ela não cobre e o que a instituição financeira precisa somar para defender um número reportado.
Por Guilherme Matos • 13 de novembro de 2026
Em banco, seguradora ou cooperativa, um normativo interno vencido que continua acessível na intranet deixa de ser só conteúdo desatualizado e passa a ser instrução operacional errada. Com o Microsoft 365 Copilot, o risco cresce, porque o assistente usa todo o conteúdo que o colaborador tem permissão de ver, inclusive a
Por Guilherme Matos • 12 de novembro de 2026
Uma instância Jira por cooperativa ou uma para o sistema inteiro? Veja os três desenhos possíveis, os critérios de decisão e o que a Resolução 4.893 permite ao sistema cooperativo.
Por Guilherme Matos • 10 de novembro de 2026
Com IA, o gestor de banco pergunta ao dado em linguagem natural em vez de esperar o relatório. Veja o que muda no time de dados com o Genie do Databricks: curadoria, testes de precisão, revisão de respostas e o histórico de perguntas como fila de demanda.
Por Guilherme Matos • 9 de novembro de 2026
Banco, cooperativa e seguradora já usam mais IA do que a TI registrou. Veja o que um inventário de IA precisa conter para servir de evidência à auditoria e ao Banco Central, de onde vêm os itens e onde manter o registro vivo no Jira Service.
Por Guilherme Matos • 5 de novembro de 2026
A Resolução 4.893 pede que o Banco Central saiba onde os dados podem ser processados. No Databricks, os recursos de IA seguem a área geográfica do workspace, que pode ir além do Brasil. Veja o que mapear antes de contratar e como configurar.