Governança de dados de conversa no Databricks: como analisar transcrições sensíveis sem escolher entre trancar e vazar
Transcrição é o dado mais sensível que entra num Lakehouse. A maioria dos projetos trava no falso dilema entre bloquear o acervo e liberar demais. Veja como o Unity Catalog resolve isso com mascaramento por política, e o que a origem precisa entregar.
Transcrição de conversa é o dado mais sensível que costuma entrar num Lakehouse: carrega nome, documento, situação financeira, condição de saúde e conflito, tudo em texto livre, dito por pessoas que não estavam preenchendo formulário. Diante disso, a maioria dos projetos de speech analytics cai num falso dilema: trancar o acervo para poucos (e a análise nunca acontece) ou liberar amplo para o time de dados (e o risco de privacidade cresce em silêncio). A saída documentada pela Databricks é separar acesso à plataforma de acesso ao dado sensível: com column masks, row filters e políticas ABAC baseadas em governed tags, o Unity Catalog aplica mascaramento no momento da consulta, por política e não por tabela. O analista enxerga o padrão sem enxergar a pessoa, e a auditoria continua rastreável.
Por que transcrição não é uma tabela como as outras
Uma tabela transacional é previsível: cada coluna tem um tipo, um significado e uma classificação de sensibilidade que se decide uma vez. Transcrição de conversa não funciona assim. O dado sensível não está numa coluna identificada, está disperso dentro de um campo de texto longo, dito de forma imprevisível. O cliente informa o CPF no meio de uma frase, menciona um diagnóstico ao justificar um atraso, cita o valor da dívida e o nome do cônjuge. Nenhum esquema de tabela antecipa isso.
Esse é o primeiro motivo pelo qual governança de dado de conversa costuma ser adiada: ela não se resolve marcando uma coluna como sensível. O segundo motivo é o volume. Uma operação de porte gera milhares de horas por mês, e o acervo cresce mais rápido do que qualquer processo manual de classificação consegue acompanhar. O resultado prático é que muitas empresas resolvem por omissão: deixam o acervo parado, sem análise e sem governança, acumulando risco de retenção sem gerar valor analítico.
A tese deste guia: o dilema entre trancar e liberar é falso, e ele nasce de confundir acesso à plataforma com acesso ao dado. São duas decisões diferentes, e tratá-las como uma só é o que trava projeto de speech analytics em empresa regulada. Quando o mascaramento acontece no momento da consulta, por política, o time de dados pode ter acesso amplo ao ambiente sem ter acesso amplo ao conteúdo sensível. Governar deixa de ser o oposto de analisar.
Os dois lados do falso dilema (e por que ambos saem caro)
Trancar: o acervo que só gera custo
A reação conservadora é restringir o acervo de transcrições a um grupo mínimo, geralmente compliance e jurídico. Parece prudente e tem um efeito colateral silencioso: o dado mais rico da operação vira arquivo morto com custo de armazenamento e obrigação de retenção, sem nenhum retorno analítico. A empresa paga para guardar o que não usa, e continua tomando decisão de atendimento por percepção.
Liberar: o risco que ninguém vê crescer
A reação oposta é dar ao time de dados acesso completo ao acervo, porque “é necessário para analisar”. Funciona até a primeira pergunta séria de auditoria: quem leu quais conversas, com qual finalidade, e por que um analista de churn precisava ver o texto integral de um atendimento sobre cobrança. O risco aqui não é hipotético nem raro, e a resposta “todo mundo do time tem acesso” é a pior possível diante de um questionamento de privacidade.
Os dois caminhos partem da mesma premissa errada: a de que acesso é binário. Não é, e a plataforma oferece as ferramentas para provar isso.
As camadas de acesso ao dado de conversa
Antes de configurar qualquer coisa, o trabalho é definir quem precisa de qual granularidade. Na prática, os perfis se separam com clareza:
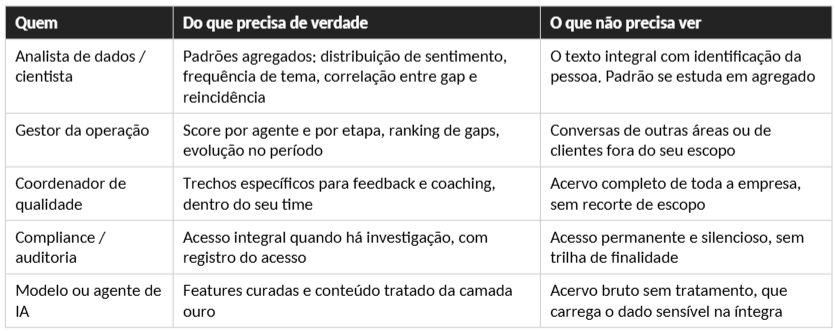
A leitura da tabela mostra o ponto central: quase ninguém precisa do texto integral identificado no dia a dia. O acesso amplo costuma ser configurado por conveniência, não por necessidade, e é essa conveniência que aparece como achado em auditoria.
Os mecanismos oficiais do Unity Catalog para isso
A documentação da Databricks descreve controles de acesso de granularidade fina que se aplicam no momento da consulta, garantindo que o usuário não veja o valor da tabela base antes do filtro ou do mascaramento. Quatro mecanismos importam aqui:
Column masks e row filters
Column mask transforma o valor de uma coluna na hora da consulta, conforme quem está consultando. Row filter restringe quais linhas o usuário enxerga, avaliando cada linha em tempo de consulta por meio de uma função SQL registrada no catálogo. Aplicados ao dado de conversa, é o que permite que o mesmo conjunto de transcrições entregue conteúdo tratado para o analista e conteúdo integral para o compliance em investigação, sem duplicar tabela nem criar cópias paralelas, que é como o dado sensível costuma vazar de verdade.
Dynamic views
A Databricks documenta as dynamic views como visões SQL que envolvem uma ou mais tabelas base, filtrando linhas, mascarando colunas ou remodelando o dado, tipicamente controladas por funções de pertencimento a grupo como
is_account_group_member(). É o caminho para expor uma versão curada e transformada do acervo a quem não deve ter acesso às tabelas subjacentes.
-- exemplo conceitual: visão que só entrega conteúdo tratado
CREATE VIEW conversas_analise AS SELECT ... FROM conversas_base
-- com column mask aplicada ao campo de transcrição
ABAC com governed tags: a mudança de escala
Configurar máscara tabela por tabela funciona em ambiente pequeno e quebra em escala. A própria Databricks descreve o problema: regras configuradas por objeto são repetitivas e sujeitas a inconsistência, com lógicas de mascaramento diferentes para o mesmo tipo de coluna, regras desatualizadas em tabelas antigas e definições conflitantes entre times. A resposta anunciada como disponibilidade geral são as políticas ABAC (controle de acesso por atributo), que se ligam ao catálogo ou ao schema e se aplicam automaticamente às tabelas conforme os governed tags, em vez de exigirem configuração individual. Some-se a isso a classificação automática de dado, que detecta o sensível conforme ele aparece.
A frase que resolve o falso dilema, na formulação da própria Databricks: o objetivo é que usuários e agentes possam receber acesso amplo à plataforma sem receber acesso amplo ao dado sensível. É exatamente a separação que projetos de speech analytics precisam para destravar. O time de dados trabalha no ambiente inteiro; o conteúdo sensível continua protegido por política, não por confiança.
O que a origem precisa entregar antes do Lakehouse
Governança de conversa não começa na plataforma de dados, começa em quem captura e processa a conversa. A Sayvox, plataforma de speech analytics da CSP Tech, documenta no material oficial do produto conformidade com a LGPD e retenção alinhada, criptografia TLS 1.2+ e AES-256, dados isolados na instância e auditoria rastreável. Esses requisitos importam por um motivo prático: se a origem não isola nem audita, nenhuma política aplicada no destino recompõe a rastreabilidade perdida antes da ingestão.
O desenho maduro trata as duas pontas como um sistema só: a origem garante captura, retenção e auditoria conforme a política da empresa; o Lakehouse garante que o acesso analítico ao mesmo dado obedeça à mesma política, com mascaramento por perfil e linhagem de ponta a ponta. Quando as duas pontas divergem, é comum descobrir que o dado restrito na origem circula amplo no destino, ou o contrário, análise travada por permissão que ninguém sabe justificar.
A camada jurídica, com a ressalva devida
A LGPD (Lei 13.709/2018) estabelece princípios que incidem diretamente sobre acervo de conversa, entre eles finalidade, necessidade e transparência. Traduzidos para arquitetura, eles empurram na mesma direção que este guia: usar o mínimo de dado necessário para cada finalidade, o que é precisamente o que o mascaramento por perfil implementa em termos técnicos.
Duas ressalvas honestas. Primeira: este texto trata da arquitetura técnica, não de aconselhamento jurídico. Questões como a base legal aplicável ao tratamento, o prazo de retenção adequado e a eventual classificação da voz como dado biométrico dependem de contexto, finalidade e avaliação do jurídico ou do DPO da empresa, e não devem ser decididas pela engenharia de dados sozinha. Segunda: nenhuma configuração de plataforma substitui política de privacidade e aviso adequado aos titulares. A tecnologia executa a política; ela não a cria.
Quando esse nível de rigor é exagero
• Acervo sem dado pessoal relevante. Se as conversas analisadas são internas, técnicas e sem dado de terceiros (reuniões de time sobre processo, por exemplo), o peso da camada de mascaramento cai bastante. O rigor deve ser proporcional à sensibilidade real.
• Piloto de escopo fechado com dado controlado. Um piloto sobre amostra pequena, com grupo restrito e prazo definido, pode rodar com controle mais simples e ressalva explícita. O erro é promover o piloto a produção sem revisitar o modelo de acesso.
• Antes de existir política corporativa de privacidade. Se a empresa ainda não definiu finalidade, retenção e base legal para o acervo de conversa, configurar máscara sofisticada é executar uma política que não existe. A ordem correta é política primeiro, implementação depois.
Perguntas frequentes
Dá para analisar transcrições sem expor dado pessoal?
Sim, e é o desenho recomendado. Com column masks e row filters do Unity Catalog, o mascaramento acontece no momento da consulta, conforme o perfil de quem consulta, sem que o usuário veja o valor da tabela base antes do tratamento. O analista enxerga padrão agregado e conteúdo tratado; o acesso integral fica reservado a perfis específicos, com trilha de auditoria.
Qual a diferença entre configurar máscara por tabela e usar ABAC?
Máscara por tabela é configurada individualmente e funciona bem em poucos objetos. A própria Databricks aponta que essa abordagem é repetitiva e propensa a inconsistência em escala. As políticas ABAC se ligam ao catálogo ou ao schema e se aplicam automaticamente conforme governed tags, cobrindo inclusive tabelas novas à medida que são marcadas, o que resolve o problema de regra desatualizada e definição conflitante entre times.
Preciso anonimizar antes de ingerir a transcrição?
Depende da finalidade e da política da empresa, e é uma decisão que envolve jurídico ou DPO. Do ponto de vista de arquitetura, há duas abordagens combináveis: preservar o original em camada de acesso restrito, com linhagem e auditoria, e servir versões tratadas nas camadas de consumo por mascaramento. O risco de anonimizar cedo demais é perder informação necessária para investigação legítima; o risco de nunca tratar é ampliar a exposição.
Isso vale também para agentes de IA que consomem o acervo?
Vale, e com atenção redobrada, porque agente que consulta dado herda o alcance de quem o executa. A orientação da Databricks é justamente permitir acesso amplo à plataforma sem acesso amplo ao dado sensível, o que se aplica igualmente a pessoas e a agentes. Na prática, o agente deve consumir a camada curada, e não o acervo bruto.
Próximo passo
Se a sua empresa tem acervo de conversa parado por receio de privacidade, ou análise rodando com acesso amplo que não sobreviveria a uma auditoria, o problema não é escolher entre governar e analisar. É que o modelo de acesso ainda não foi desenhado. Solicite um diagnóstico de governança de dados de conversa com a CSP Tech e receba o mapa das duas pontas: o que a origem precisa garantir e como o mascaramento por política destrava a análise no Lakehouse sem ampliar exposição.
Autor: Guilherme Matos, estrategista de conteúdo e IA, certificado HubSpot, Google e Anthropic. Revisão técnica por especialistas de dados da CSP Tech (parceira Databricks, Microsoft Gold Partner, Atlassian Gold Partner, 34 anos de mercado, produtos próprios Power BI for Jira e Sayvox).
Fontes (oficiais, acesso jul/2026): Databricks Documentation, “Row filters and column masks” e “Manually apply row filters and column masks” (docs.databricks.com/data-governance/unity-catalog/filters-and-masks); Databricks Documentation, “Attribute-based access control in Unity Catalog” e tutorial de configuração de ABAC (docs.databricks.com/data-governance/unity-catalog/abac); Databricks Blog, anúncio de disponibilidade geral de políticas ABAC de row filtering e column masking, governed tags e classificação de dados (databricks.com/blog, mai/2026); Databricks Documentation, Unity Catalog (docs.databricks.com/data-governance/unity-catalog). White Paper e material oficial SAYVOX (CSP Tech, jun/2026) para requisitos de segurança na origem. Lei 13.709/2018 (LGPD) para os princípios citados. Este conteúdo trata de arquitetura técnica e não constitui aconselhamento jurídico.