Dados do Jira no Databricks: quando a pergunta do gestor passa do teto do BI
O Jira guarda anos de história operacional que o BI lê só de forma descritiva. Veja quando esse dado justifica o Databricks Lakehouse, como ingerir via conector oficial Lakeflow Connect e o que o Unity Catalog governa.
O ativo de dados que a TI enterprise já tem e não explora
Uma instância de Jira de empresa de porte, com cinco ou dez anos de uso, guarda milhões de registros: quem fez o quê, quanto tempo cada tipo de trabalho levou, onde as filas se formam, quais times dependem de quais, o texto de cada decisão discutida em comentário. É um dos retratos mais fiéis da operação que a empresa possui, mais fiel que qualquer relatório declarado, porque foi registrado no ato do trabalho, não na prestação de contas.
E o uso típico desse ativo é raso: relatórios operacionais do próprio Jira e, nas empresas mais maduras, dashboards executivos no Power BI. Ambos respondem à pergunta descritiva (o que está acontecendo). O que quase ninguém faz é tratar o Jira como fonte de dados enterprise, cruzável com ERP, CRM e financeiro, capaz de alimentar análise preditiva e agentes de IA. Não por falta de valor no dado, mas porque a arquitetura de BI não foi feita para esse tipo de pergunta.
A tese deste guia: o dado do Jira tem duas vidas. A primeira é operacional-descritiva, e o BI resolve bem. A segunda é analítica em escala: cruzamento entre domínios, previsão e contexto para IA. Essa segunda vida exige plataforma de dados com governança unificada, e é aí que o Lakehouse entra. Confundir as duas vidas gera dois erros simétricos: subusar um ativo valioso, ou comprar plataforma para pergunta que o BI já respondia.
As três perguntas que estouram o teto do BI
O critério de decisão não é a ferramenta da moda, é o tipo de pergunta que a liderança está fazendo. Três famílias de pergunta não cabem numa arquitetura só de BI:
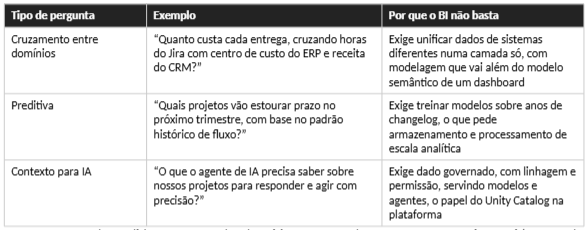
Se as perguntas da sua liderança são todas descritivas, o BI resolve e a conversa termina aqui (a seção de limitações abaixo trata disso com honestidade). Se pelo menos uma das três famílias apareceu na sua última reunião de diretoria, o dado do Jira tem uma segunda vida esperando arquitetura.
Como o dado do Jira entra no Lakehouse (os caminhos oficiais)
Caminho 1 · Conector gerenciado do Lakeflow Connect (nativo Databricks)
A Databricks documenta um conector gerenciado de Jira no Lakeflow Connect, em Beta na data de acesso desta publicação. Ele ingere as tabelas de origem (issues, comentários, worklogs, entre outras) diretamente para tabelas Delta, com pipeline governado pelo Unity Catalog, computação serverless e leitura incremental: a primeira execução traz tudo, as seguintes trazem só o que mudou. A autenticação é via OAuth criado no console de desenvolvedor da Atlassian, com suporte a Jira Cloud e Data Center, e é possível filtrar a ingestão por projetos específicos usando as chaves de projeto:
connector_options: jira_options: include_spaces: ["KEY1", "KEY2"]
Para quem já usa Confluence como camada de conhecimento, a Databricks mantém também um conector de Confluence (páginas, espaços e comentários), o que permite montar o pipeline Atlassian completo na mesma plataforma.
Caminho 2 · Pipeline customizado via REST API do Jira
Quando o cenário exige transformação específica na ingestão (reconstruir a linha do tempo de cada issue a partir do changelog, por exemplo, para análise fina de fluxo), o caminho é o pipeline sob medida usando a REST API do Jira, que expõe o histórico completo de transições via expand=changelog, conforme a documentação do Atlassian Developer. É trabalho de engenharia de dados: mais controle, mais responsabilidade de manutenção. Faz sentido quando o conector gerenciado não entrega o recorte de que a análise precisa.
E onde o Power BI continua sendo a resposta
A camada executiva descritiva não muda de lugar. Dashboards de fluxo, visão de portfólio e indicadores para a diretoria continuam sendo território do Power BI, alimentado de forma governada. É o problema que a CSP Tech resolve com o Power BI for Jira, conector no-code no Atlassian Marketplace. As duas camadas coexistem: o Power BI responde “o que está acontecendo” para o executivo; o Lakehouse responde as três famílias de pergunta que estouram o teto do BI. Arquitetura madura tem as duas, cada uma no seu papel, sem duplicar governança.
O que o Unity Catalog governa quando o Jira vira fonte enterprise
Dado operacional carrega informação sensível: nomes, avaliações implícitas em comentários, horas trabalhadas por pessoa, detalhes de cliente em issues de suporte. Levar isso para uma plataforma de dados sem governança transformaria um ativo em passivo. Na arquitetura Databricks, o pipeline do Lakeflow Connect nasce governado pelo Unity Catalog, o que significa: controle de acesso por tabela e coluna, linhagem de onde cada dado veio, auditoria de quem consultou o quê, e as mesmas permissões valendo para o analista, o notebook e o modelo de IA que consomem o dado. É o pré-requisito para a segunda vida do dado do Jira não virar problema de compliance.
O ponto onde a consultoria dupla faz diferença: esse pipeline tem dois lados que precisam estar saudáveis ao mesmo tempo. Do lado Atlassian, um Jira com workflow sujo e campo preenchido por obrigação produz um Lakehouse de dado sujo, mais rápido e em maior volume. Do lado Databricks, ingestão sem desenho de governança expõe dado sensível em escala. Quem opera só um dos lados resolve metade do problema. A CSP Tech, parceira Atlassian Gold e parceira Databricks, atua nos dois: higiene e arquitetura da instância Jira na origem, e desenho do pipeline e da governança no destino.
Quando o Lakehouse é exagero (e o BI basta)
• Todas as perguntas são descritivas. Se a liderança quer ver fluxo, gargalo e portfólio, o Power BI sobre dado governado do Jira resolve com custo e complexidade menores. Não compre plataforma para pergunta que o dashboard já responde.
• A higiene do Jira ainda não existe. Ingerir milhões de registros de uma instância mal configurada industrializa o dado ruim. A ordem é a de sempre: workflow e campos saudáveis na origem, depois o pipeline.
• Não há caso de uso além do Jira. O Lakehouse compensa quando o dado do Jira cruza com outros domínios ou alimenta IA. Se o Jira seria a única fonte na plataforma, o investimento provavelmente está na frente da necessidade.
Perguntas frequentes
Existe conector oficial entre Jira e Databricks?
Sim. A Databricks documenta um conector gerenciado de Jira no Lakeflow Connect (em Beta na data de acesso), que ingere issues, comentários e worklogs para tabelas Delta com governança do Unity Catalog, leitura incremental e autenticação OAuth, com suporte a Jira Cloud e Data Center. Há também um conector de Confluence para a camada de conhecimento.
Levar o Jira para o Databricks substitui o Power BI?
Não. São camadas com papéis diferentes. O Power BI segue respondendo a pergunta descritiva do executivo (fluxo, gargalo, portfólio), que a CSP atende com o Power BI for Jira. O Lakehouse entra quando a pergunta cruza domínios, exige previsão ou alimenta IA. Arquitetura madura mantém as duas, cada uma no seu papel.
Que dado do Jira vale a pena ingerir?
Depende da pergunta de negócio. Para análise de fluxo e previsão, o histórico de transições (changelog) é o núcleo, junto com issues e worklogs. Para contexto de IA e busca, comentários e descrições pesam mais. O conector do Lakeflow Connect permite filtrar por projeto, e recortar a ingestão pelos projetos relevantes acelera a primeira sincronização, conforme a documentação da Databricks.
O dado do Jira tem informação sensível. Como fica a governança?
Esse é o ponto central da arquitetura. O pipeline do Lakeflow Connect nasce governado pelo Unity Catalog: acesso por tabela e coluna, linhagem, auditoria, e as mesmas permissões valendo para pessoas, notebooks e modelos. O desenho dessas permissões é trabalho de arquitetura, não de configuração padrão.
Próximo passo
Se a sua liderança já fez pelo menos uma das três perguntas que estouram o teto do BI, o dado que responde a ela provavelmente já existe no seu Jira, esperando arquitetura. Solicite um diagnóstico de dados operacionais com a CSP Tech e mapeie, dos dois lados do pipeline, o que precisa estar saudável para o dado do Jira ganhar a segunda vida.
Autor: Guilherme Matos, estrategista de conteúdo e IA, certificado HubSpot, Google e Anthropic. Revisão técnica por especialistas Atlassian e de dados da CSP Tech (Atlassian Gold Partner, parceira Databricks, Microsoft Gold Partner, 34 anos de mercado, produto próprio Power BI for Jira no Atlassian Marketplace).
Fontes (oficiais, acesso jul/2026): Databricks Documentation, “Managed connectors in Lakeflow Connect”, “Managed SaaS connectors”, “Jira connector”, “Ingest data from Jira” e “Jira connector reference” (docs.databricks.com/ingestion/lakeflow-connect); Databricks, “Lakeflow Connect” (databricks.com/product/data-engineering/lakeflow-connect); Atlassian Developer, “Jira Cloud platform REST API”, uso de expand=changelog (developer.atlassian.com). CSP Tech, Power BI for Jira, conector no-code no Atlassian Marketplace.