Do legado à nuvem: modernize os sistemas core sem parar sua operação

Romildo Burguez • July 11, 2025

Nenhum CIO quer ser lembrado como o executivo que “derrubou o faturamento” porque decidiu atualizar o sistema de pedidos em plena virada de trimestre. Ainda assim, continuar rodando o mesmo código de dez ou quinze anos atrás custa cada vez mais caro — em licenças, em falta de talento capaz de dar manutenção e, principalmente, em oportunidades de negócio que ficam na mesa porque novas ideias esbarram na rigidez do legado. 


A boa notícia é que modernização de sistemas core e continuidade operacional não precisam ser interesses opostos. Nos últimos anos, surgiram padrões de arquitetura, práticas de engenharia e serviços de nuvem que viabilizam uma transição gradual, enxuta e mensurável.  


Nesse post, você encontrará um passo a passo testado em empresas que faturam centenas de milhões de reais, operam sob rígidos SLAs e são auditadas de forma rigorosa — para migrar sistemas críticos do legado para a nuvem sem interromper o seu negócio.  


Quer saber como isso é possível? Continue a leitura! 


O ponto de partida certo: diagnóstico de risco e valor 


Toda jornada de modernização começa com uma pergunta simples: qual parte do core mais limita o crescimento do negócio hoje? Pode ser o tempo que o batch de faturamento leva para fechar o mês, a instabilidade durante picos de vendas ou a impossibilidade de expor APIs para novos parceiros. 


Para responder com objetividade: 


Mapeie fluxos de receita e compliance: liste quais módulos sustentam etapas críticas de cobrança, cálculo tributário, estoque regulado ou registro de operações fiscais. 


Colete dados de dor real: latência na ponta, custo de infraestrutura, horas gastas em incidentes P1, multas por atraso em relatórios obrigatórios. 


Estime janela de intervenção tolerada: mesmo ambientes 24x7 costumam ter minutos de folga que podem ser aproveitados, desde que identificados. 


Esse “raio-X” revela duas coisas: onde a modernização de sistemas core gera maior retorno imediato e quanto risco se pode assumir em cada sprint de mudança. 


Quebrar para construir: encapsulamento antes da reescrita 


Tentar reescrever um monólito de anos em uma tacada só é a rota mais curta para o fracasso. O segredo está em encapsular primeiro, refatorar depois. 


Criando a casca protetora (API Gateway ou Proxy) 


Coloque um layer na frente do sistema: ele intercepta chamadas, autentica usuários, aplica rate-limit e, de quebra, coleta métricas em tempo real. Nada muda para quem está do lado de fora, mas você ganha a alavanca para redirecionar tráfego quando o primeiro microsserviço estiver pronto. 


Padrão Strangler Fig 


Em vez de “derrubar e reconstruir”, envolve-se o módulo herdado com serviços novos. Um a um, esses serviços assumem funcionalidades específicas (por exemplo, cálculo de ICMS ou consulta de limite de crédito). Quando 100% das requisições migram, o pedaço legado é aposentado — sem nenhum segundo de indisponibilidade. 


O maior benefício? Feedback constante do mundo real. Cada pequena vitória valida a arquitetura, motiva o time e gera um caso de uso concreto para convencer áreas vizinhas. 


Dados: o coração que nunca pode parar 


Código ruim se reescreve; dados perdidos não voltam. Por isso, a modernização de sistemas core só funciona quando a estratégia de informação é tão robusta quanto o código. 


Change Data Capture (CDC) 


Ferramentas como Debezium ou Fleet por streaming replicam alterações do banco legado em tempo quase real para um repositório moderno. Assim, novos serviços podem ler dados frescos sem enfileirar transações no mainframe. 


Event Streaming 


Transforme cada insert, update ou delete em evento publicado no Kafka. Serviços consumidores criam projeções próprias (materialized views) e rodam lógicas independentes. Caso algo falhe, basta reprocessar o log — e o estado se reconstrói. 


Shadow writes e validação 


Durante a migração, escreva em paralelo no banco antigo e no novo. Relatórios de consistência rodam em background até que qualquer divergência fique abaixo de um limiar definido com a área de negócio. Só então a fonte da verdade troca de lugar. 


Resultado: nenhuma virada arriscada, dados íntegros e auditoria feliz. 


Esteira de deploy pensada para Zero-Downtime 


Nada adianta ter microsserviços fantásticos se o go-live precisar de sábado inteiro parado. 


Três práticas tornam a mexida quase invisível: 


Blue-Green Deployment: dois ambientes idênticos; o load balancer aponta para o verde quando o check de saúde confirma estabilidade. Reversão é trocar o ponteiro de volta. 


Canary Release: começa com 1% do tráfego, avança para 5%, 20%, 50%. Se o alerting pegar algo estranho, basta congelar a progressão. 


Feature Toggles: a funcionalidade nova existe em produção, porém desligada. Liga-se para grupos de controle e, só depois, para todos. Isso separa deploy técnico de lançamento comercial, dando paz ao marketing e ao desenvolvedor. 


Com essa tríade, janelas de manutenção viram exceção, não regra. 


Segurança e compliance “shift left” 


Empresas de setores consolidados respondem a reguladores: BACEN, SUSEP, ANP, ANVISA ou quem quer que fiscalize seu nicho. Qualquer brecha de dados custa caro — e modernizar não pode abrir flanco. 


Infra-as-Code: Terraform ou CloudFormation garantem que toda modificação vira commit versionado. Auditoria encontra o “quem fez o quê” em minutos. 


Pipeline de segurança automatizado: testes SAST/DAST e varredura de dependências rodam em cada build; uma CVE crítica bloqueia o deploy antes de chegar à nuvem. 


Data Masking dinâmico: amostras de produção, usadas por squads de analytics, chegam ofuscadas por padrão, preservando LGPD e SOX sem atrito. 


O resultado é um SOS jurídico zerado: aquilo que antes dependia de planilha manual agora sai de logs assinados digitalmente. 


Governança de custo e performance na nuvem 


Migrar para nuvem sem controle vira boleto surpresa. Por isso, cada microsserviço ganha limites claros de: 


Orçamento mensal: budgets e alerts enviam e-mail (ou Slack) se o gasto diário extrapolar a média histórica. 


Autoscaling preditivo: modelo de ML simples (geralmente baseado em sazonalidade) prevê pico e sobe units antes de o usuário sentir lentidão. 


Tagueamento obrigatório: nome do sistema, squad responsável e centro de custo acompanham o recurso desde o primeiro terraform apply. 


Dessa forma, a modernização de sistemas core entrega elasticidade sem causar descontrole nas despesas operacionais. 


O lado humano: cultura, processo e comunicação 


Tecnologia não move sozinha. Três pilares garantem que o pessoal compre a mudança: 


Transparência radical: dashboards públicos (para TI e negócio) exibem SLAs, incidentes e economia real. O ceticismo se dissolve diante de números. 


Treinamento hands-on: devs que mexiam em COBOL (linguagem comum orientada para os negócios) recebem labs de contêiner e pipelines; ao ver o ganho de tempo, viram evangelistas internos. 


Governança Lean: mantenha o comitê que aprova mudanças pequeno, com pessoas de negócio que falam a dor em linguagem de valor (“cada 1 h de indisponibilidade custa X em vendas”). Isso agiliza e dá propósito. 


Com o clima certo, ninguém luta contra a modernização; ao contrário, pede para ser o próximo módulo contemplado. 


Métricas que importam para o board 


Modernizar por amor à engenharia não sustenta orçamento. Use indicadores que o CFO entende: 
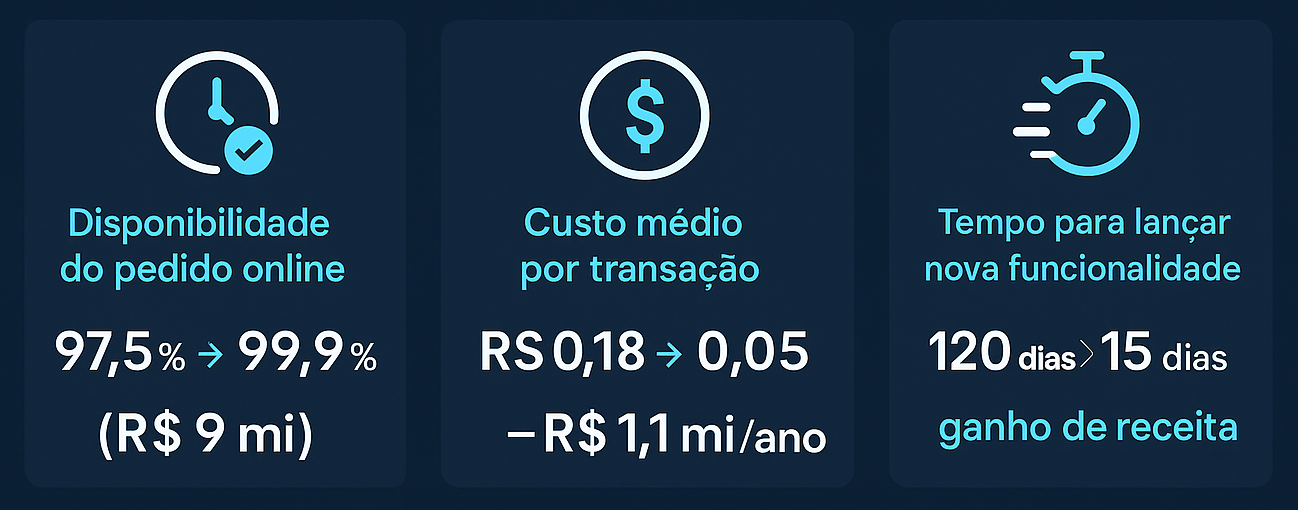
Esses números sustentam o argumento de que a modernização de sistemas core não é capricho, e sim investimento de retorno rápido. 


Caso condensado: precificação em tempo real no atacado 


Uma distribuidora B2B sofria lentidão diária às 18h, quando representantes fechavam pedidos. O algoritmo de preço morava no mainframe; processava lote, não evento. 


  • Encapsulamento pelo API Gateway em 4 semanas. 
  • Microsserviço de precificação containerizado em linguagem moderna, rodando em EKS. 
  • CDC replicou a tabela de estoque para DynamoDB em latência inferior a 3 segundos. 
  • Canary com 2% de pedidos durante um feriado local — zero divergência. 


Resultado no primeiro mês: 26% mais pedidos aprovados no horário crítico, R$ 3 mi de faturamento extra e três incidentes P1 a menos. A diretoria, antes reticente, aprovou a expansão para o módulo de crédito antes do fim do trimestre. 


Checklist final antes do “go” 


  • Contrato de risco e valor alinhado a cada sprint. 
  • Backlog priorizado com quick wins de alto impacto visível. 
  • Pipeline CI/CD com automação de testes, segurança e governança. 
  • Modelo de dados híbrido (legacy + nuvem) com replicação em tempo real. 
  • Estratégia de rollback clara — se o canário gritar, volte ao azul. 
  • Métricas de negócio publicadas desde o primeiro deploy. 


Se três itens ainda estiverem pendentes, o time não avança. Disciplina é o que separa projetos épicos de dores de cabeça intermináveis. 


Para que você possa se aprofundar ainda mais, recomendamos também a leitura dos artigos abaixo:       


O papel de um parceiro de tecnologia na transformação digital 


Como desenvolver software em ambientes legados com segurança e eficiência 


Sistemas Core: Como projetos estruturantes transformam a eficiência operacional 


Quanto custa NÃO modernizar? Calculando o ROI de projetos core em empresas consolidadas 


Conclusão 


“Não podemos parar” deixou de ser desculpa para engavetar projetos de modernização. 


Hoje, padrões de arquitetura, serviços gerenciados de nuvem e esteiras de automação permitem evoluir o core com operação 24x7 intacta. O segredo é encapsular antes de refatorar, sincronizar dados em tempo real, automatizar testes e deploys, e medir valor em reais desde a primeira entrega. 


Ao seguir os passos descritos — diagnóstico de risco, Strangler Fig, pipeline zerodowntime, segurança shift left e governança de custo — o legado deixa de ser âncora e vira ponto de partida para iniciativas de inteligência de dados, canais digitais e modelos de receita até então inviáveis. 


A estrada não é isenta de curva, mas está pavimentada: empresas em setores regulados já comprovaram que a modernização de sistemas core pode acontecer em ritmo de sprint, sem desligar a engrenagem que sustenta o faturamento.  


Esperamos que você tenha gostado do conteúdo desse post!  


Caso você tenha ficado com alguma dúvida, entre em contato conosco, clicando aqui! Nossos especialistas estarão à sua disposição para ajudar a sua empresa a encontrar as melhores soluções do mercado e alcançar grandes resultados! 


Para saber mais sobre as soluções que a CSP Tech oferece, acesse: www.csptech.com.br. 

Fale com a CSP Tech

.

Por Guilherme Matos • 19 de novembro de 2026
Para usar agentes de IA sobre dados de sinistro sem expor dado pessoal do segurado, o agente precisa herdar a mesma regra de acesso do analista que faz a pergunta, aplicada no momento da consulta. No Databricks, isso depende de duas escolhas. A primeira é o modo de autorização do agente: na autorização por usuário , o agente consulta os dados com a identidade de quem pergunta, e o Unity Catalog aplica automaticamente filtros de linha e máscaras de coluna; na autorização do app, todos os usuários compartilham as permissões de uma conta técnica. A segunda é não contornar as máscaras com cópias de dados feitas para alimentar a busca vetorial. Em sinistros de vida, saúde e acidentes pessoais, parte desses dados é dado de saúde, que a LGPD trata como dado pessoal sensível. Por que o dado de sinistro pede um cuidado diferente Um processo de sinistro reúne dados de identificação do segurado e dos beneficiários, dados bancários para indenização, relatos do evento e, em vários ramos, laudos e informações médicas. A Lei Geral de Proteção de Dados define, no artigo 5º, inciso II, o dado referente à saúde como dado pessoal sensível, e o artigo 11 limita as hipóteses em que ele pode ser tratado. Entre elas estão o exercício regular de direitos, inclusive em contrato, e a garantia da prevenção à fraude. O artigo 6º, inciso III, acrescenta o princípio da necessidade: o tratamento deve se limitar ao mínimo necessário para a sua finalidade. Na operação, esse princípio já costuma estar refletido em perfis de acesso. O regulador de sinistro vê o processo que conduz, o time antifraude vê os sinais de que precisa, e o atendimento vê o status do pedido sem acessar o laudo. O risco do agente de IA é desfazer essa separação sem que ninguém perceba, porque ele responde em linguagem natural e não mostra de qual tabela, com qual permissão, tirou cada informação. Tese da CSP Tech: na seguradora, o agente de IA deve ver exatamente o que o analista que fez a pergunta veria, nem mais nem menos, e essa regra precisa ser aplicada no momento da consulta, pela plataforma de dados, e não por instruções no prompt. No Databricks, os dois pontos em que o dado do segurado costuma escapar são a escolha da autorização do agente e as cópias feitas para busca vetorial, e ambos se resolvem no desenho, antes do piloto. Os dois modos de autorização do agente Autorização do app Segundo a documentação da Databricks, atualizada em 23 de outubro de 2026, na autorização do app o agente se autentica com uma conta técnica criada automaticamente, e todos os usuários compartilham as mesmas permissões. É o modo mais simples de colocar um piloto no ar, e por isso é o mais comum. O efeito em um ambiente de sinistros é direto: se a conta técnica tem acesso ao laudo médico, qualquer pessoa que converse com o agente pode receber uma resposta baseada nele, ainda que o perfil dessa pessoa não permita abrir o laudo. Autorização por usuário Na autorização por usuário, antes chamada de on-behalf-of-user, o agente acessa os recursos com a identidade de quem faz a pergunta. A documentação lista como benefícios o acesso por usuário a dados sensíveis, os controles granulares do Unity Catalog, a trilha de auditoria por usuário e a aplicação automática de filtros de linha e máscaras de coluna. O recurso funciona com SQL Warehouse, Genie, Model Serving, índices de AI Search e tabelas do Unity Catalog, entre outros. Os dois modos podem ser combinados no mesmo agente, o que permite usar a conta técnica para recursos sem dado pessoal e a identidade do usuário para os que têm. Há três cuidados registrados pela própria Databricks. A autorização por usuário está em prévia pública e precisa ser habilitada por um administrador do workspace. As mudanças de escopo podem levar até cinco minutos para valer, por causa de caches. E, se o token do usuário não chegar ao agente, a função que deveria usar a identidade dele recorre à conta técnica sem gerar erro. Por isso a documentação recomenda testar o agente com uma ferramenta que devolva a identidade em uso antes de liberar o acesso. Filtros de linha e máscaras de coluna: a regra aplicada na consulta No Unity Catalog, filtros de linha e máscaras de coluna restringem, no momento da consulta, quais linhas e quais valores cada usuário consegue ver, segundo a documentação de filtros e máscaras , atualizada em 6 de novembro de 2026. O filtro de linha é uma função que exclui as linhas para as quais retorna falso, o que permite, por exemplo, que o regulador veja só os processos da sua carteira. A máscara de coluna é uma função que devolve o valor original ou uma versão mascarada, o que permite mostrar o diagnóstico ao time médico e um valor oculto ao atendimento. Para aplicar a mesma regra a muitas tabelas, a Databricks recomenda políticas baseadas em atributos, ligadas a tags no catálogo ou no esquema, que os donos das tabelas não conseguem remover. Combinadas com a autorização por usuário, essas regras fazem o agente herdar o perfil do analista sem nenhuma instrução no prompt. Uma instrução do tipo “não revele dados de saúde” pode ser contornada por uma pergunta bem formulada, enquanto a máscara aplicada pela plataforma impede que o dado chegue ao modelo. Onde o dado do segurado escapa A cópia para busca vetorial. A documentação informa que tabelas com filtros de linha ou máscaras de coluna não podem ser usadas para criar um índice do AI Search. Quando o time de dados quer que o agente pesquise documentos de sinistro, a saída mais rápida é criar uma cópia sem as proteções para indexar, e com isso o índice passa a conter o que as máscaras escondiam. O desenho seguro prepara uma tabela própria para o índice, já sem os campos sensíveis ou com eles transformados, e aplica a autorização por usuário ao índice. Os clones e as versões antigas. Clones de tabelas com filtros ou máscaras não são suportados, e a consulta a versões anteriores da tabela, o time travel, não funciona com filtros e máscaras em nível de tabela. Ambientes de teste montados com cópias de produção são um caminho conhecido para o dado sensível sair do perímetro. As views. Filtros e máscaras não podem ser aplicados diretamente a uma view. Se o agente consulta uma view construída sobre a tabela original, a proteção precisa estar na tabela de origem. O fallback silencioso. Quando o token do usuário não chega ao agente, a consulta passa a usar a conta técnica sem erro. O teste de identidade em uso precisa fazer parte da homologação e do monitoramento, e não só do primeiro deploy. O que a seguradora precisa decidir antes do piloto A plataforma aplica as regras, mas não as define. Antes de liberar o agente, a seguradora precisa classificar quais colunas de sinistro são dado pessoal e quais são dado de saúde, decidir quais perfis podem ver cada classe, registrar essas decisões como tags governadas no catálogo e escolher, recurso por recurso, se o agente usa a identidade do usuário ou a conta técnica. Essa classificação é o mesmo trabalho de governança de dados que a seguradora já precisaria fazer para a LGPD, agora aplicado a um consumidor novo, que responde a perguntas em vez de abrir telas. O caso de dados de conversa, com mascaramento de gravações e transcrições, está tratado no artigo “Governança de dados de conversa no Databricks” , publicado no blog. Aqui o foco é o agente que consulta o processo de sinistro. A camada regulatória, com a ressalva devida A LGPD exige, no artigo 46, medidas de segurança técnicas e administrativas aptas a proteger os dados pessoais de acessos não autorizados, e não prescreve ferramenta. No mercado de seguros, a Circular Susep 638/2021 trata de segurança cibernética e determina a comunicação de incidentes relevantes à autarquia. A leitura de que o agente de IA deve herdar a regra de acesso do analista é uma interpretação editorial da CSP Tech sobre como aplicar o princípio da necessidade a um novo tipo de consumidor de dados. A base legal de cada tratamento, a classificação dos dados e a avaliação de impacto cabem ao encarregado de dados e às áreas de compliance e jurídico da seguradora. Quando esse desenho é desproporcional Um agente que trabalha só com dados agregados ou anonimizados, como volume de sinistros por ramo e região, não precisa de autorização por usuário: a conta técnica com acesso apenas a essas tabelas resolve. O mesmo vale para um agente interno que responde sobre normas e procedimentos, sem acesso a processos de segurados. O cuidado descrito aqui é para o agente que consulta processos individuais. Perguntas frequentes Dado de sinistro é dado pessoal sensível? Parte dele é. A LGPD, no artigo 5º, inciso II, classifica o dado referente à saúde como dado pessoal sensível, e processos de sinistro de vida, saúde e acidentes pessoais costumam conter laudos e informações médicas. Dados de identificação e bancários do segurado são dados pessoais, ainda que não sensíveis. O que é autorização por usuário em agentes do Databricks? É o modo em que o agente acessa os dados com a identidade de quem faz a pergunta, antes chamado de on-behalf-of-user. Com ele, o Unity Catalog aplica automaticamente filtros de linha e máscaras de coluna. Segundo a documentação da Databricks de outubro de 2026, o recurso está em prévia pública e precisa ser habilitado por um administrador do workspace. Posso indexar no AI Search uma tabela com máscaras de coluna? Não. A documentação da Databricks informa que tabelas com filtros de linha ou máscaras de coluna não podem ser usadas para criar um índice do AI Search. O caminho seguro é preparar uma tabela própria para o índice, sem os campos sensíveis ou com eles transformados, em vez de copiar a tabela original sem proteção. Uma instrução no prompt basta para o agente não revelar dados de saúde? Não é uma proteção confiável, porque pode ser contornada por perguntas bem formuladas. A forma mais segura é impedir que o dado chegue ao modelo, aplicando máscaras de coluna e filtros de linha na plataforma de dados e fazendo o agente consultar com a identidade do usuário. Próximo passo Faça um teste de dez minutos: no agente que sua equipe está testando sobre dados de sinistro, faça a mesma pergunta com dois usuários de perfis diferentes, um do atendimento e outro da regulação, e compare as respostas. Depois, verifique se o índice de busca do agente foi criado a partir de uma cópia da tabela original. Se as respostas forem iguais, ou se o índice veio de uma cópia sem máscaras, o agente está vendo mais do que o analista. Solicite um diagnóstico de dados da CSP Tech para desenhar a autorização e as máscaras antes de ampliar o piloto. Leituras relacionadas Governança de dados e IA Segurança de agentes de IA: por que permissão virou o novo perímetro (e como limitar o agente sem inutilizá-lo) Data lake ou pântano de dados: por que a IA não fracassa por falta de dado, e sim por não achar o dado certo MDM no Databricks: como construir gestão de dados mestres no Lakehouse (sem comprar mais uma plataforma) Por que 40% dos projetos de agentes de IA serão cancelados até 2027 (e o que a fundação de dados tem a ver com isso) Setor financeiro e seguros Agentes de IA não autorizados chegaram às contas bancárias dos EUA. Seus sistemas sabem quem está do outro lado? Empresa de intranet para banco, cooperativa ou seguradora: como comparar plataforma pronta, SharePoint e desenvolvimento sob medida “De onde veio esse número”? Rastreabilidade de dados para decisões mais confiáveis Autor: Guilherme Matos, estrategista de conteúdo e IA, certificado HubSpot, Google, Anthropic e Semrush. Revisão técnica por especialistas Atlassian e de dados da CSP Tech (Atlassian Gold Partner, parceira Databricks, Microsoft Gold Partner, participante do Anthropic Partner Network, 38 anos de mercado, produto próprio Power BI for Jira no Atlassian Marketplace). Fontes (acesso em 19/11/2026): Databricks Documentation, “Authentication for AI agents” (autorização do app e por usuário; prévia pública; fallback sem erro; recursos suportados), atualizada em 23/10/2026. Databricks Documentation, “Row filters and column masks” (avaliação em tempo de consulta, políticas ABAC, limitações com AI Search, clones, time travel e views), atualizada em 06/11/2026. Lei nº 13.709/2018 (LGPD) , arts. 5º (II), 6º (III), 11 e 46, texto compilado no Planalto. Circular Susep nº 638/2021 . A tese e as práticas de desenho são formulação editorial da CSP Tech. Este conteúdo não constitui aconselhamento jurídico ou regulatório.
Por Guilherme Matos • 18 de novembro de 2026
Scripts envenenados em quatro serviços web, DDoS contra a rede Tor: como cada ataque de novembro de 2026 funcionou e o que revisar em cada camada.
Por Guilherme Matos • 17 de novembro de 2026
Com o Pix funcionando 24 horas, a mudança segura em pagamentos é a que chega à janela com o caminho de volta testado e registrado. Veja como estruturar janela, aprovação e rollback.
Por Guilherme Matos • 16 de novembro de 2026
A linhagem do Unity Catalog mostra de onde veio cada coluna, mas tem limites documentados. Veja o que ela não cobre e o que a instituição financeira precisa somar para defender um número reportado.
Por Guilherme Matos • 13 de novembro de 2026
Em banco, seguradora ou cooperativa, um normativo interno vencido que continua acessível na intranet deixa de ser só conteúdo desatualizado e passa a ser instrução operacional errada. Com o Microsoft 365 Copilot, o risco cresce, porque o assistente usa todo o conteúdo que o colaborador tem permissão de ver, inclusive a
Por Guilherme Matos • 12 de novembro de 2026
Uma instância Jira por cooperativa ou uma para o sistema inteiro? Veja os três desenhos possíveis, os critérios de decisão e o que a Resolução 4.893 permite ao sistema cooperativo.
Por Guilherme Matos • 10 de novembro de 2026
Com IA, o gestor de banco pergunta ao dado em linguagem natural em vez de esperar o relatório. Veja o que muda no time de dados com o Genie do Databricks: curadoria, testes de precisão, revisão de respostas e o histórico de perguntas como fila de demanda.
Por Guilherme Matos • 9 de novembro de 2026
Banco, cooperativa e seguradora já usam mais IA do que a TI registrou. Veja o que um inventário de IA precisa conter para servir de evidência à auditoria e ao Banco Central, de onde vêm os itens e onde manter o registro vivo no Jira Service.
Por Guilherme Matos • 5 de novembro de 2026
A Resolução 4.893 pede que o Banco Central saiba onde os dados podem ser processados. No Databricks, os recursos de IA seguem a área geográfica do workspace, que pode ir além do Brasil. Veja o que mapear antes de contratar e como configurar.